MCP trên AWS Fargate: cổng dữ liệu dùng chung cho nhiều AI agent
AWS chia sẻ kiến trúc MCP server không máy chủ trên ECS Fargate, dùng metadata để mở dữ liệu mới và tập trung kiểm soát quyền của nhiều AI agent.
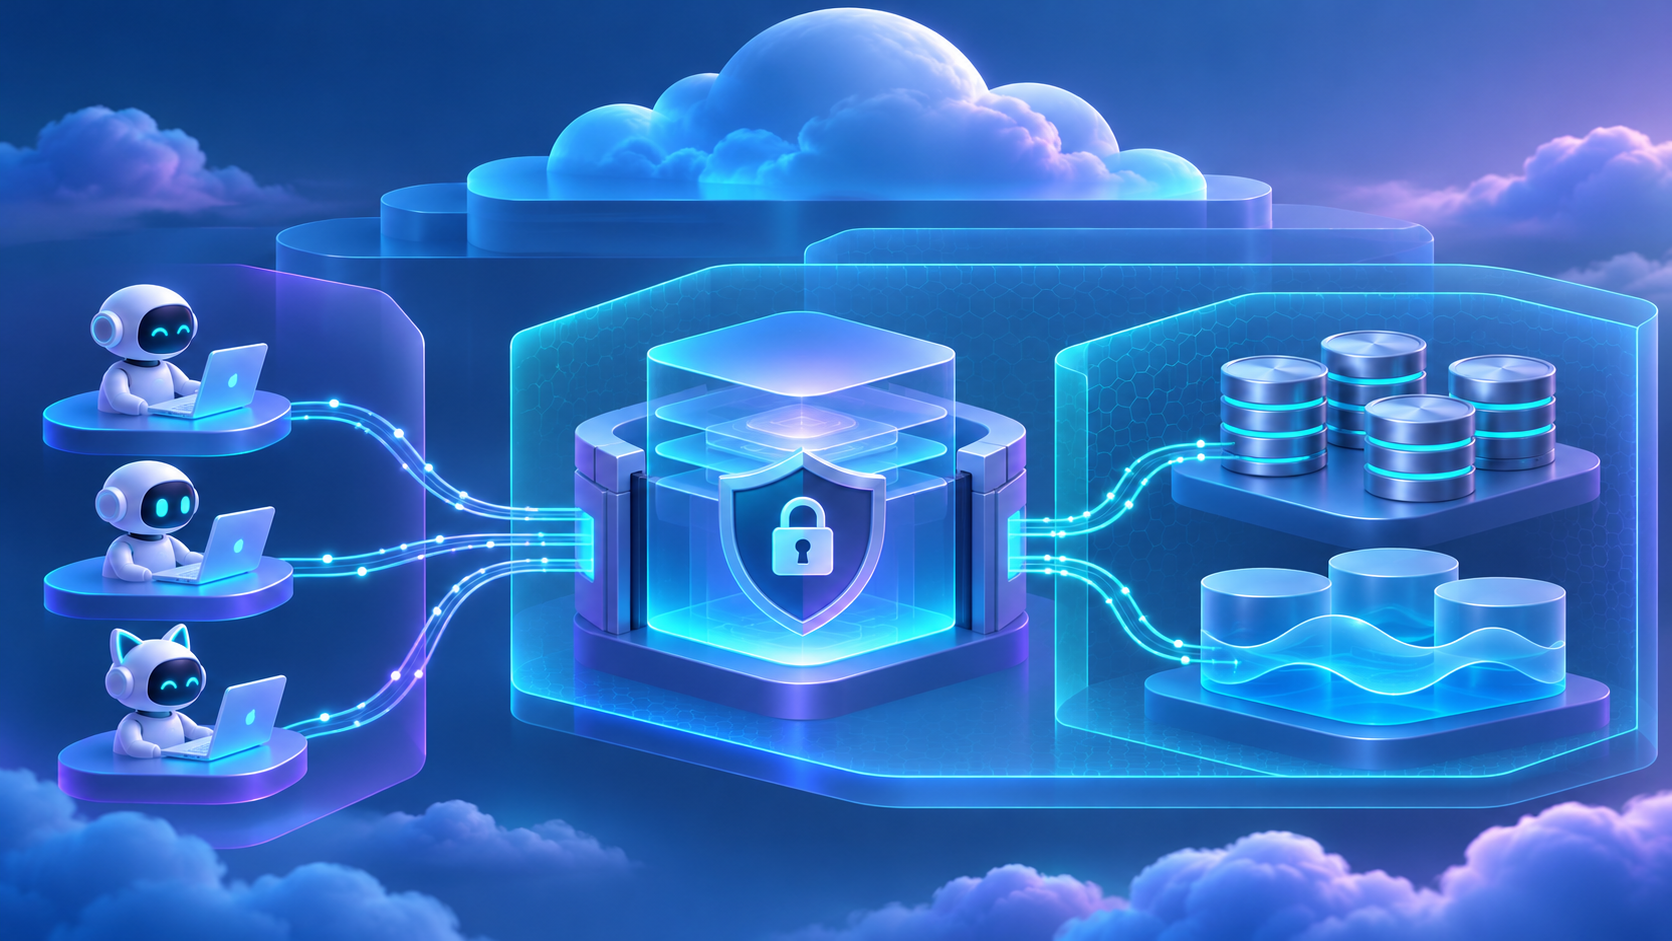
Khi mỗi chatbot tự nối vào cơ sở dữ liệu, quyền truy cập, câu SQL và nhật ký thường bị phân tán. Ngày 06/11/2026, AWS công bố một kiến trúc tham khảo dùng MCP server trên ECS Fargate làm cổng chung giữa AI agent và data lake. Bài viết dành cho kiến trúc sư giải pháp và đội phát triển agent cần gom chính sách mà không biến cổng dữ liệu thành một tài khoản toàn quyền.
MCP server giải quyết bài toán gì?
MCP, viết tắt của Model Context Protocol, là giao thức để ứng dụng AI khám phá và gọi công cụ theo một cách thống nhất. Trong kiến trúc AWS công bố, dữ liệu mới được mô tả bằng tệp JSON thay vì viết một công cụ riêng cho từng bảng. Agent gọi cùng một lớp công cụ, còn cổng trung tâm xử lý xác thực, chọn nguồn và kiểm tra truy vấn.
AWS xây mẫu này cho dữ liệu vận hành của mạng lưới phân loại tại Bắc Mỹ. Đây là kinh nghiệm của một hệ thống cụ thể, không phải sản phẩm tự động bật lên là an toàn cho mọi doanh nghiệp.
Luồng yêu cầu trong kiến trúc
Application Load Balancer chuyển người dùng tới Amazon Cognito để xác thực. Lớp client trong private subnet giữ trạng thái hội thoại ở DynamoDB, sau đó gọi MCP server qua load balancer nội bộ. MCP server chạy FastMCP, dùng Amazon Bedrock để phân tích yêu cầu và gọi công cụ tới Athena, Redshift hoặc Bedrock Knowledge Bases.
Fargate làm các task không giữ trạng thái lâu dài; task có thể được thay thế hoặc co giãn, còn phiên nằm trong DynamoDB. Cách tách này giảm phụ thuộc vào một container, nhưng bổ sung nhiều ranh giới cần quan sát: Cognito, hai load balancer, mạng riêng, session store, model và backend dữ liệu.
Điểm mạnh là kiểm soát tập trung, không phải bỏ qua phân quyền
Một gateway dùng chung tạo nơi duy nhất để ghi nhật ký và áp chính sách. Tuy nhiên, nếu MCP server dùng một role có quyền đọc mọi bảng rồi tự lọc bằng prompt, rủi ro vẫn rất lớn. Quyền phải được kiểm tra bằng danh tính và chính sách máy đọc được trước khi chạy công cụ; mô hình không nên là lớp quyết định cuối.
- Gắn danh tính người dùng và agent vào mọi lời gọi công cụ, không chỉ lưu trong nội dung hội thoại.
- Giới hạn mỗi tool bằng IAM, phạm vi bảng, cột và khu vực dữ liệu; tránh một role dùng chung quá rộng.
- Kiểm tra câu SQL theo danh sách cho phép, giới hạn thời gian, lượng dữ liệu quét và số hàng trả về.
- Che hoặc loại dữ liệu nhạy cảm trước khi đưa vào ngữ cảnh mô hình.
- Ghi lại ai gọi agent nào, tool nào, chính sách nào cho phép và dữ liệu nào được trả về.
Metadata giúp mở rộng nhưng cũng là bề mặt tấn công
Tệp metadata giúp onboarding nguồn mới nhanh hơn, nhưng thay đổi cấu hình có thể mở nhầm bảng hoặc mô tả sai trường dữ liệu. Metadata nên nằm trong kho mã có xét duyệt, kiểm thử schema, ký phiên bản và triển khai qua pipeline. Không cho agent tự ghi metadata của chính nó.
Đội vận hành cũng cần chống prompt injection trong dữ liệu. Một tài liệu chứa câu lệnh giả không được phép thay đổi chính sách IAM hoặc làm agent gọi công cụ vượt quyền. Nội dung lấy từ data lake là dữ liệu không tin cậy, kể cả khi nằm trong tài khoản của doanh nghiệp.
Checklist trước khi đưa vào hệ thống phục vụ khách hàng
- Vẽ ma trận người dùng, agent, tool và nguồn dữ liệu; mọi ô không cần thiết phải mặc định bị từ chối.
- Tách lớp client khỏi MCP server bằng private subnet và load balancer nội bộ như kiến trúc mẫu.
- Lưu trạng thái tối thiểu, mã hóa DynamoDB và đặt thời hạn tự xóa cho phiên không còn dùng.
- Đặt quota cho truy vấn Athena/Redshift, giới hạn kết quả và theo dõi chi phí theo agent.
- Kiểm thử prompt injection, truy vấn vượt tenant, đường dẫn lỗi và hành vi khi backend chậm.
- Ghi log quyết định cho phép/từ chối mà không đưa khóa truy cập hoặc dữ liệu nhạy cảm vào log.
- Chuẩn bị cơ chế tắt một tool hoặc một nguồn dữ liệu mà không phải dừng toàn bộ gateway.
Khi nào nên dùng mẫu này?
Mô hình gateway phù hợp khi nhiều agent cần dùng chung nguồn dữ liệu và doanh nghiệp muốn một điểm audit. Nếu chỉ có một ứng dụng, vài API ổn định và quyền đơn giản, một lớp dịch vụ chuyên biệt có thể dễ bảo vệ hơn MCP tổng quát. Serverless ở đây nghĩa là không quản lý máy chủ EC2 trực tiếp, không có nghĩa là không còn việc vận hành.
Nguồn tham khảo
Nguồn chính: AWS, Serverless MCP server for AI agent data lake access on Amazon ECS Fargate, 06/11/2026. Các lựa chọn dịch vụ trong bài là kiến trúc tham khảo của AWS.
MCP server có thay thế IAM không?
Không. MCP chuẩn hóa việc gọi công cụ; IAM và chính sách dữ liệu vẫn phải quyết định danh tính nào được phép truy cập tài nguyên nào.
Fargate có làm MCP server hoàn toàn không trạng thái không?
Task Fargate có thể không giữ trạng thái, nhưng phiên hội thoại và dữ liệu nghiệp vụ vẫn cần một kho bên ngoài như DynamoDB.
Một gateway dùng chung có tạo điểm lỗi tập trung không?
Có thể. Cần nhiều task, load balancer, kiểm tra sức khỏe, giới hạn tải và cơ chế tắt từng tool để giảm phạm vi sự cố.
Bước tiếp theo
Đội phát triển có thể gửi danh sách agent, nguồn dữ liệu, hệ thống danh tính, yêu cầu lưu log và ranh giới tenant qua trang liên hệ. Mục tiêu là dựng ma trận quyền và một thử nghiệm nhỏ trước khi cho agent chạm tới dữ liệu thật.
Cần máy chủ cho workload này?
NOC thuemaychu.vn hỗ trợ chọn CPU, GPU và băng thông. PoC trong 24 giờ.
Bài viết liên quan
 GPU / AI
Agent Substrate 1.0 trên GKE: chạy AI agent không giữ pod nhàn rỗi
Agent Substrate tách trạng thái agent khỏi máy chạy, đưa worker nhàn rỗi về pool và khôi phục phiên khi cần. Google công bố GA trên GKE ngày 05/11.
 GPU / AI
NVIDIA NemoClaw: bộ khung mở để tự chủ AI agent
NVIDIA giới thiệu NemoClaw ngày 30/10/2026 như một bộ khung mở kết nối agent harness, Nemotron, NeMo và OpenShell. Bài viết phân tích giá trị, giới hạn và checklist thử nghiệm cho đội phát triển AI.
 Data Center
AWS Lambda hỗ trợ Kafka queue: tăng song song không cần thêm partition
Lambda có chế độ Queue cho self-managed Kafka event source mapping. Bài viết giải thích khi nào nên dùng, đánh đổi về thứ tự và checklist chuyển đổi an toàn.