 GPU / AI
AgentCore thêm GPU G7 dùng RTX PRO 4500 Blackwell
AgentCore hỗ trợ EC2 G7 với GPU RTX PRO 4500 Blackwell Server Edition. Đội AI cần kiểm tra vùng, bộ nhớ và vòng đời phiên trước khi triển khai.
Hướng dẫn cho sysadmin, DevOps và kỹ sư hạ tầng AI. Chọn cấu hình GPU, dedicated, VPS và Data Center trước khi thuê máy.
GPU / AIAgentCore hỗ trợ EC2 G7 với GPU RTX PRO 4500 Blackwell Server Edition. Đội AI cần kiểm tra vùng, bộ nhớ và vòng đời phiên trước khi triển khai.
 GPU / AI
NVIDIA hướng dẫn dùng Dynamo để điều phối tạo mẫu học tăng cường. Đội AI nên đo mẫu được chấp nhận, thời gian chờ và phục hồi trước khi thuê thêm GPU.
 GPU / AI
Cloudflare mở trọng số mô hình trích xuất Clairic và Clairic-flash. Đội AI có thể thử đọc tài liệu tiếng Việt, đo lỗi và chọn cách triển khai.
 GPU / AI
Lambda Managed Instances hỗ trợ GPU cho tác vụ AI theo sự kiện. Đội phát triển cần kiểm tra bộ nhớ, thời gian khởi động và chi phí trước khi chuyển.
 GPU / AI
MiTAC đề xuất dùng AMD MI350X cho bước đọc đầu vào và bộ tăng tốc riêng để sinh câu trả lời. Xem khi nào đội AI nên thử tách hai bước.
 GPU / AI
NVIDIA giới thiệu Rubin HPC tại SC26 và dự kiến có vào năm 2028. Xem cách đội mô phỏng đo bài toán hiện tại trước khi chọn cấu hình GPU.
 GPU / AI
Khung đo của WEKA và NAND Research giúp đội AI so chi phí trên mỗi lượt đạt yêu cầu, cùng thời gian phản hồi và chất lượng khi thử GPU.
 GPU / AI
AMD công bố các gói suy luận đầu tiên cho MI350P. Đội AI nên chọn đúng cấu hình trong danh mục và thử chất lượng, bộ nhớ, tải đồng thời trước khi chuyển.
 GPU / AI
Titania hướng tới máy suy luận dùng hạ tầng làm mát sẵn có. Thông số thiết kế và mục tiêu của hãng cần được kiểm chứng khi có hệ thống chạy thử.
 GPU / AI
NVIDIA trình bày cách chia GLM-5.3 NVFP4 qua hai GPU GB300. Đội AI cần đo thêm bộ nhớ phiên, thời gian chờ và lưu lượng giữa hai máy.
 GPU / AI
Agent Gateway cho GKE đang ở bản xem trước. Đội phát triển có thể thử kiểm soát đường gọi công cụ ở một vùng tên riêng trước khi triển khai rộng.
 GPU / AI
MI450X thêm lựa chọn 288 GB bộ nhớ trên AMD Helios. Số đo MI455X với DeepSeek-R1 giúp tham khảo, nhưng cần thử lại bằng tải ứng dụng của mình.
 GPU / AI
NVIDIA minh họa cách đối chiếu cấu hình cụm GPU với danh mục ứng dụng AI đang chạy. Danh mục chỉ bao phủ những loại tác vụ mà công cụ nhận diện được.
 GPU / AI
Bài kỹ thuật ngày 10/11/2026 đưa ra mẫu kho dữ liệu nhật ký Bedrock nhiều tài khoản. Đây là kiến trúc tham khảo, không phải thông báo giảm giá API.
 GPU / AI
NVIDIA công bố Snapshot ngày 10/11/2026. Benchmark cho thấy khôi phục nhanh hơn khởi động từ đầu, nhưng chưa tính cấp máy và tải ảnh container.
 GPU / AI
Công bố ngày 10/11/2026 tách việc dựng phần mềm khỏi quản lý cụm GPU. Hai dự án đang ở bản xem trước, chưa được khuyến nghị cho hệ thống phục vụ khách hàng.
 GPU / AI
Thông báo ngày 09/11/2026 nhấn mạnh bảo vệ dữ liệu khi đang xử lý. Bài giúp CTO phân biệt tính năng phần cứng với bảo đảm của toàn hệ thống AI.
 GPU / AI
Hợp tác dự kiến dùng GPU cho bước đọc ngữ cảnh, NPU cho bước sinh câu trả lời. Hệ thống R200 được kỳ vọng sẵn sàng triển khai năm 2028, chưa phải lựa chọn thuê ngay.
 GPU / AI
Google đưa Cloud Pathways vào cung cấp chính thức trên GKE. Giá trị cần đánh giá là điều phối, khả năng phục hồi và chi phí hoàn tất tác vụ, không chỉ số chip.
 GPU / AI
Reshard Collective chuyển đúng phần trọng số mà GPU suy luận cần, thay vì gom rồi phát toàn bộ. Bài viết phân tích benchmark hãng và điều kiện thử nghiệm.
 GPU / AI
Cost Explorer và CUR 2.0 nay dàn phí trả trước Capacity Blocks theo kỳ đặt chỗ, giúp đội AI quy chi phí GPU cho dự án và thấy phần công suất không dùng.
 GPU / AI
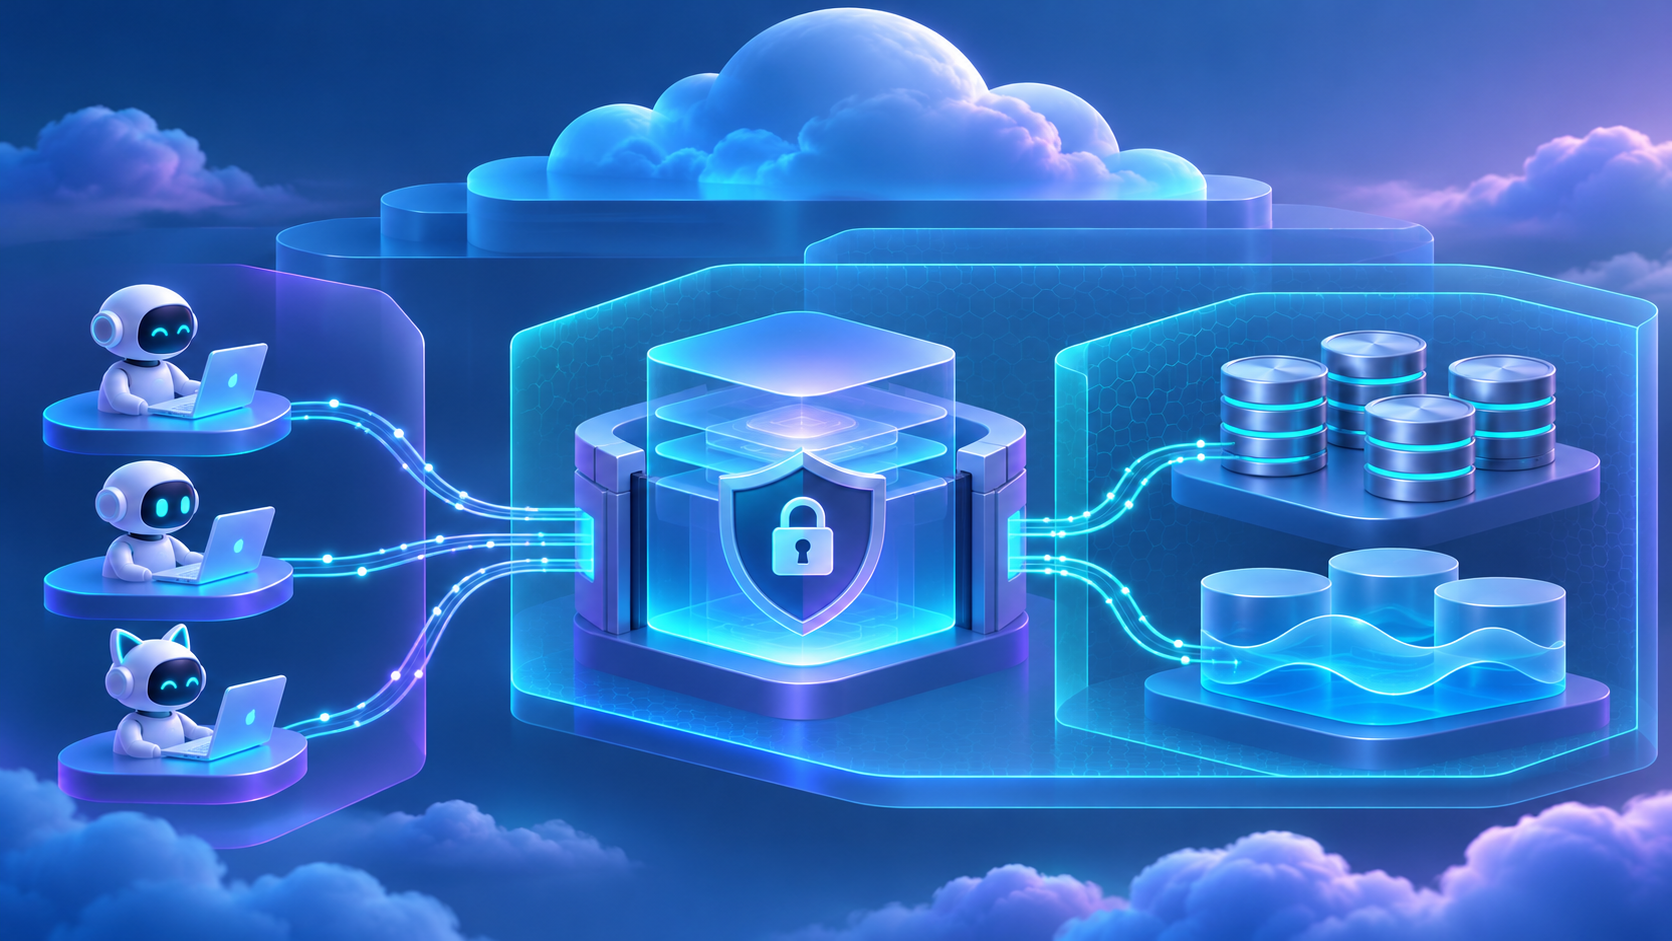
AWS chia sẻ kiến trúc MCP server không máy chủ trên ECS Fargate, dùng metadata để mở dữ liệu mới và tập trung kiểm soát quyền của nhiều AI agent.
 GPU / AI
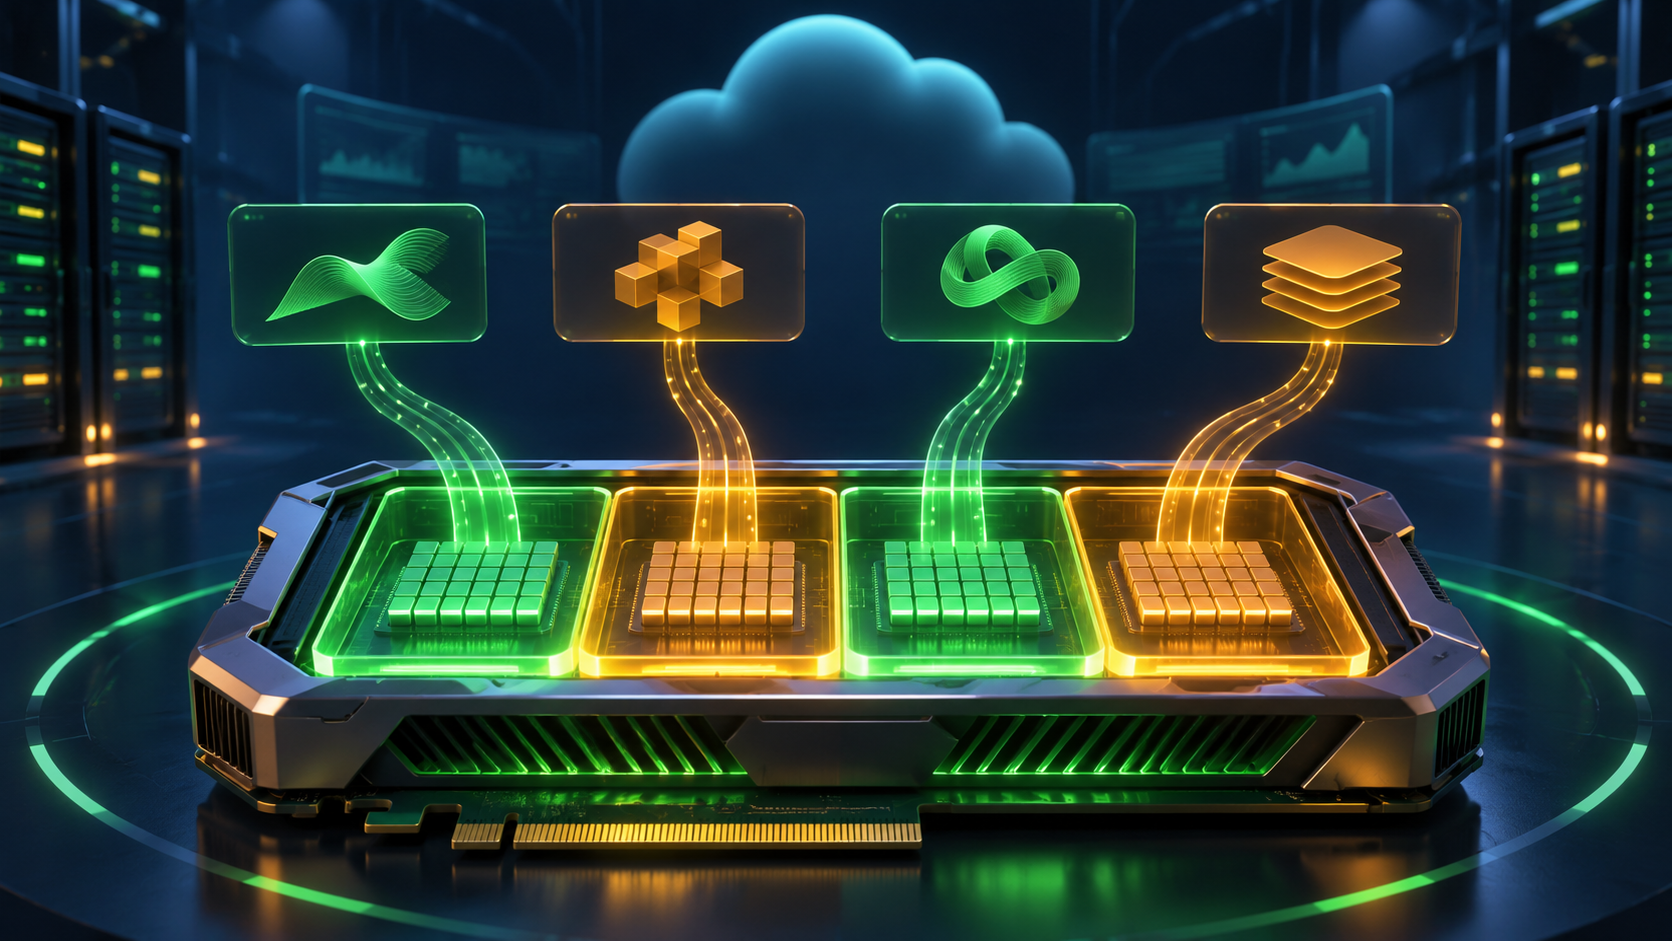
AWS bổ sung GPU partitioning cho SageMaker Inference bằng NVIDIA MIG, giúp nhiều endpoint dùng các phần GPU độc lập mà không tự vận hành Kubernetes.
 GPU / AI
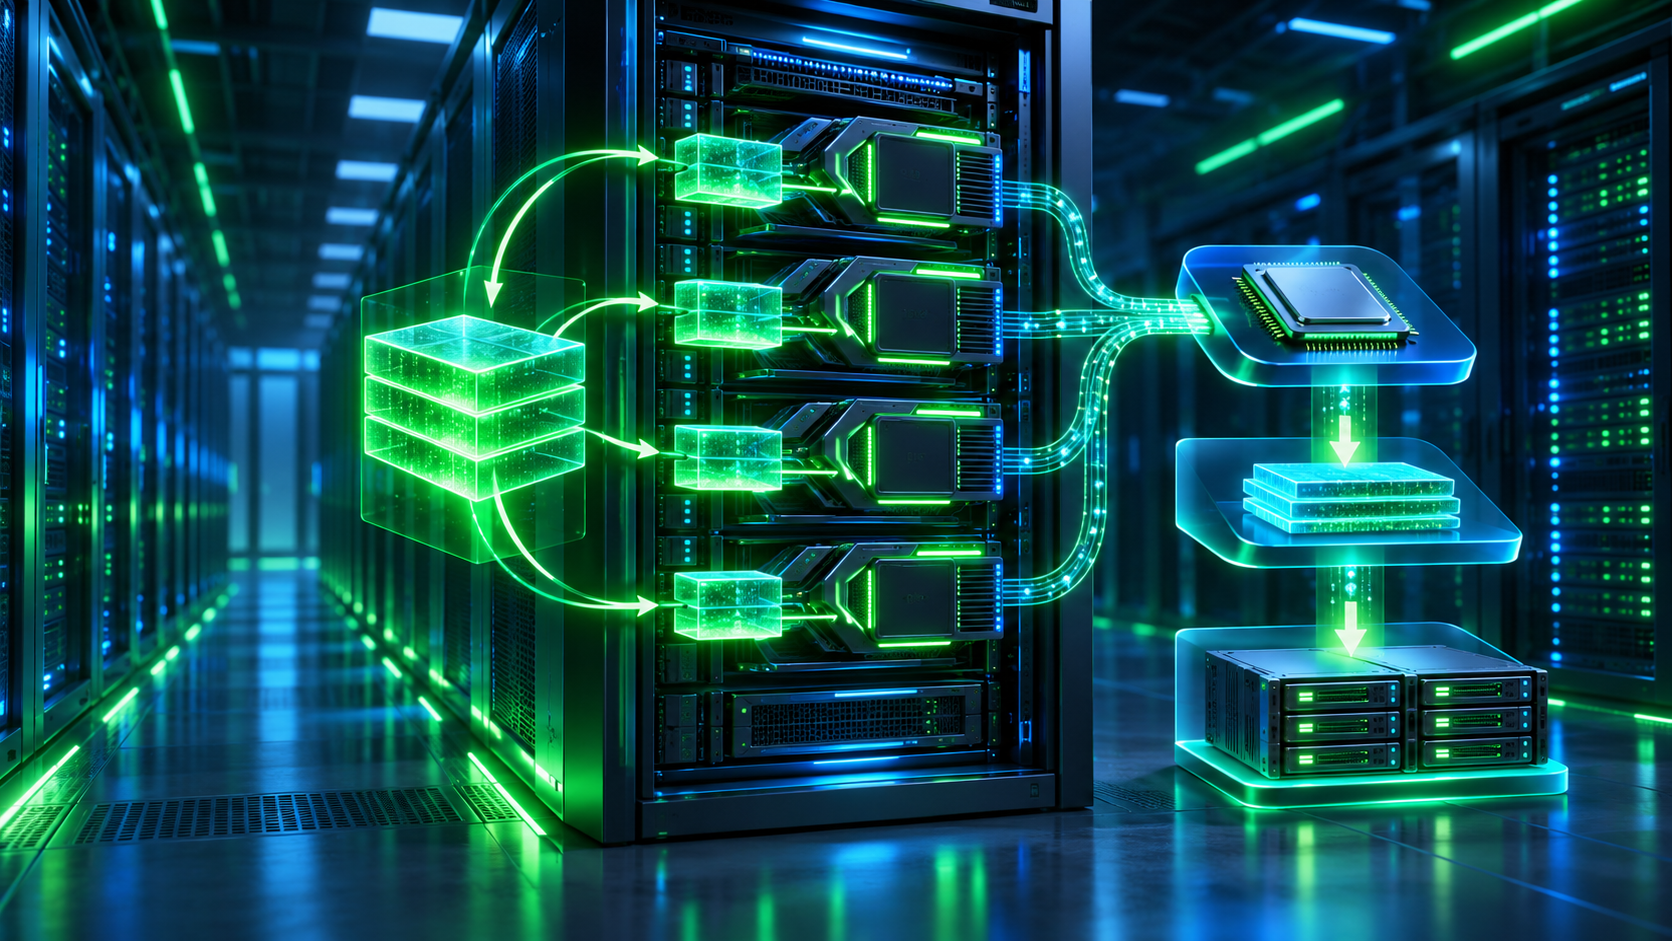
NVIDIA cho rằng hiệu quả suy luận không chỉ phụ thuộc dung lượng HBM mà còn ở độ chính xác số, cách phân bổ mô hình, định tuyến KV cache và tầng lưu trữ.
 GPU / AI
Google giới thiệu sâu AI.AGG ngày 05/11/2026: một hàm GoogleSQL chạy chỉ dẫn ngôn ngữ tự nhiên trên lượng lớn văn bản và dữ liệu đa phương thức.
 GPU / AI
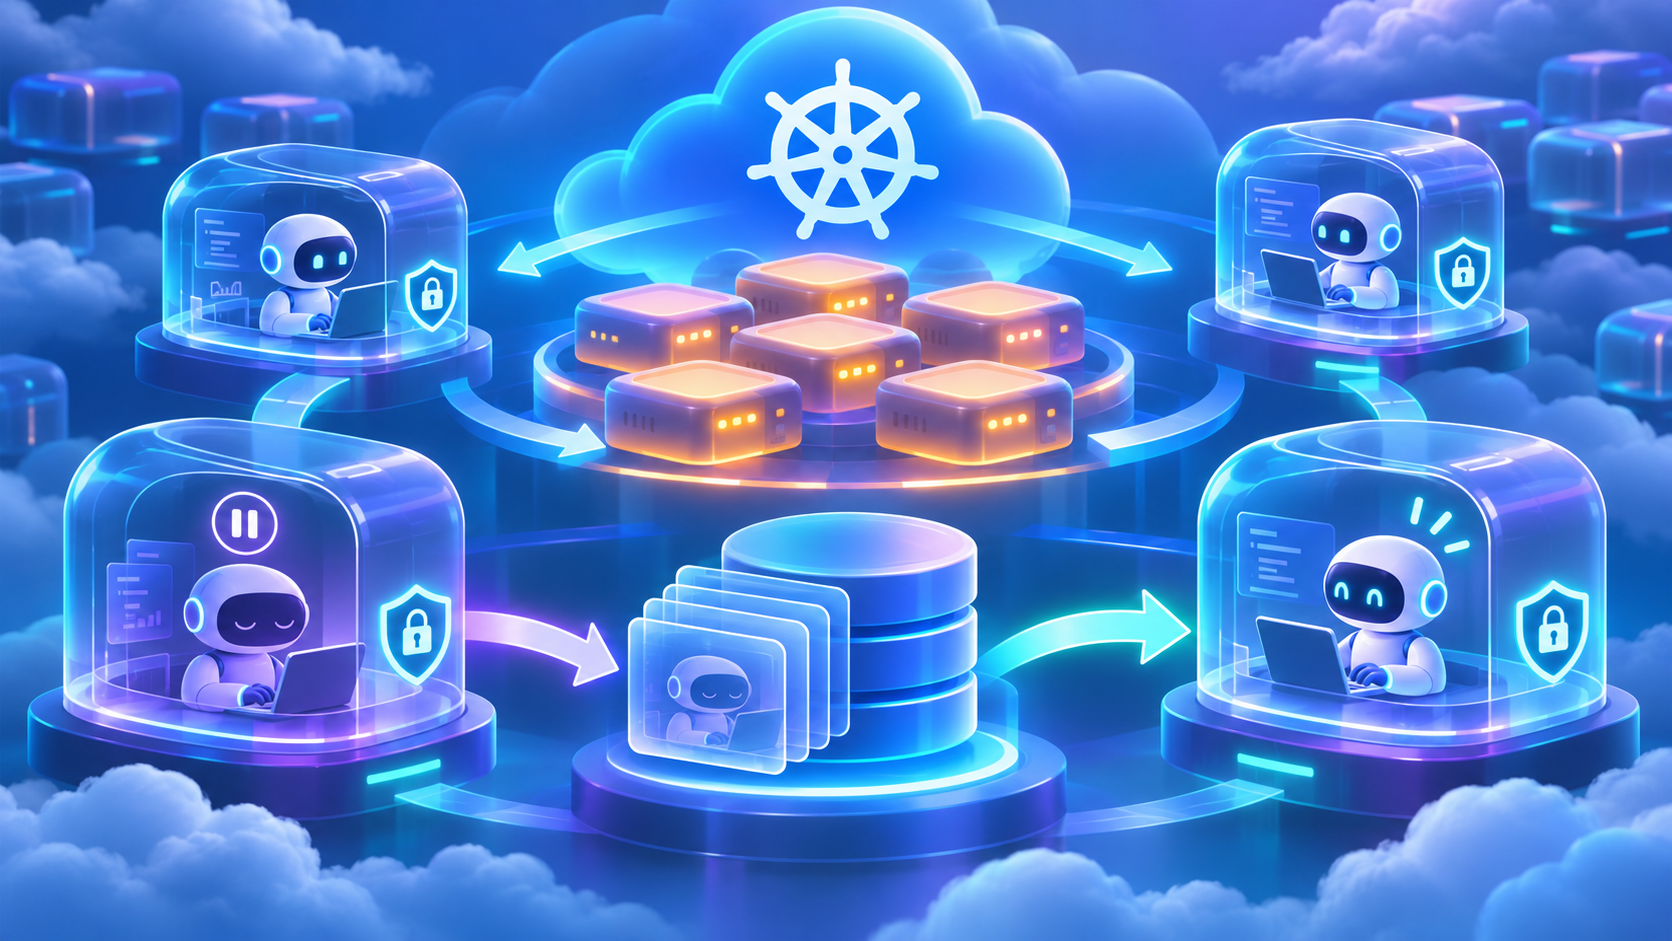
Agent Substrate tách trạng thái agent khỏi máy chạy, đưa worker nhàn rỗi về pool và khôi phục phiên khi cần. Google công bố GA trên GKE ngày 05/11.
 GPU / AI
CUDA 13.5 hỗ trợ chính thức kiến trúc Vera Rubin, đồng thời bổ sung nhiều cơ chế điều phối MPS v3. Bài viết phân tích giá trị thực tế, điều kiện áp dụng và cách thử nghiệm an toàn.
 GPU / AI
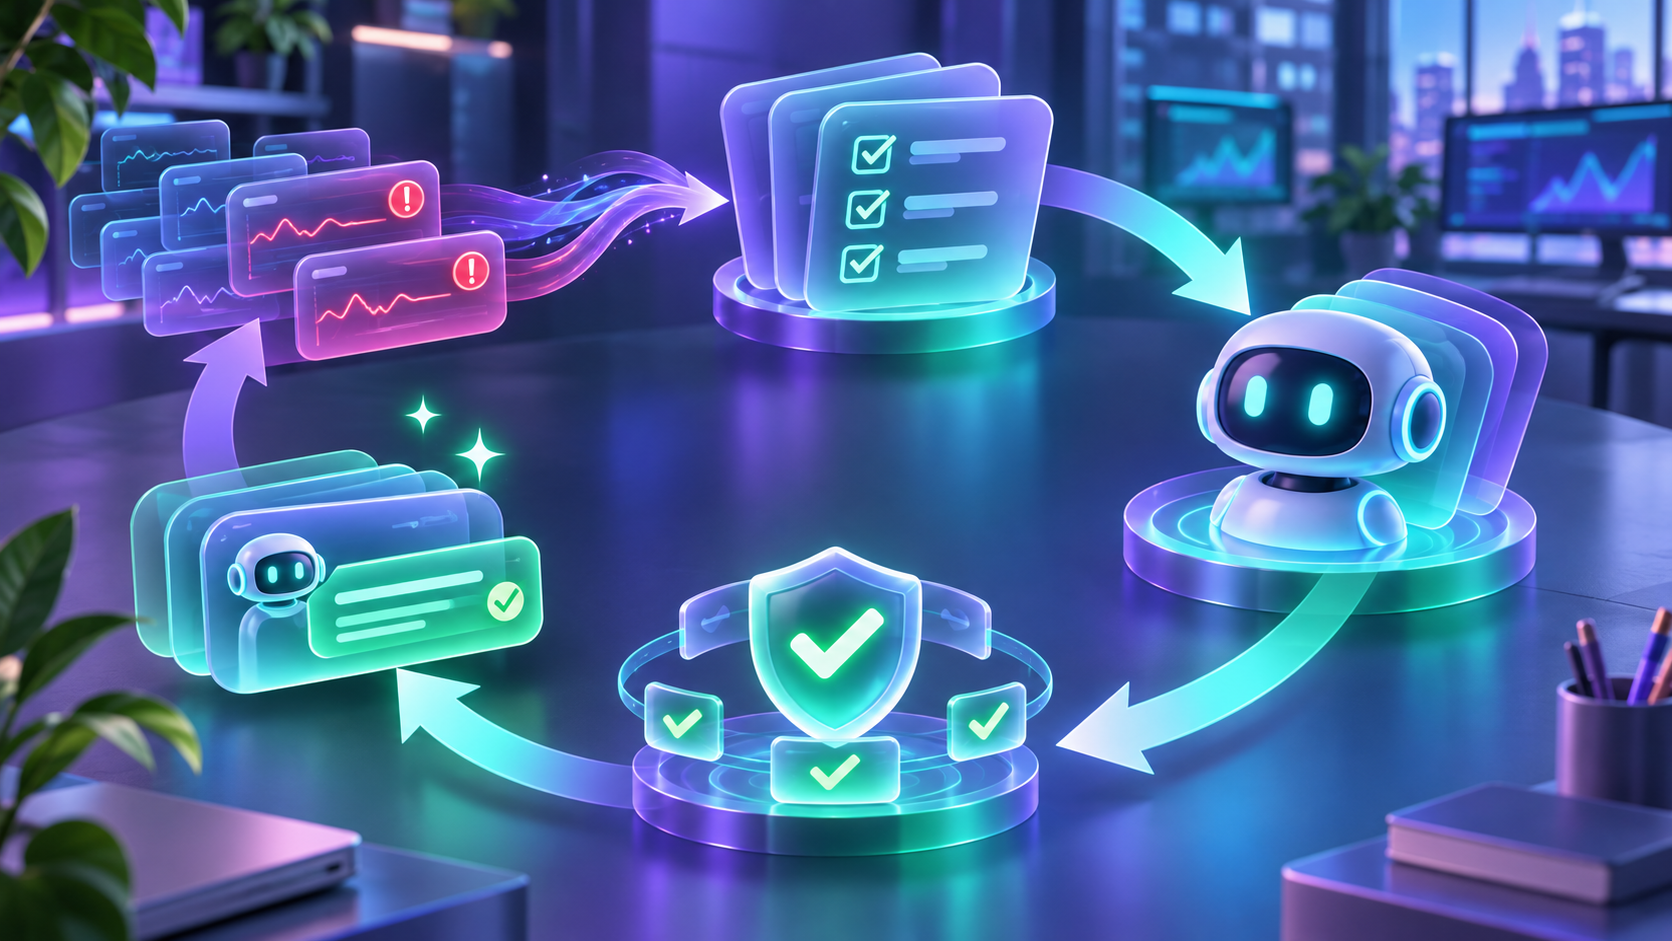
NVIDIA giới thiệu quy trình dùng trace để tìm lỗi lặp lại, tạo bài kiểm thử và sửa lớp điều khiển AI agent. Đây là cách áp dụng có kiểm soát cho đội phát triển.
 GPU / AI
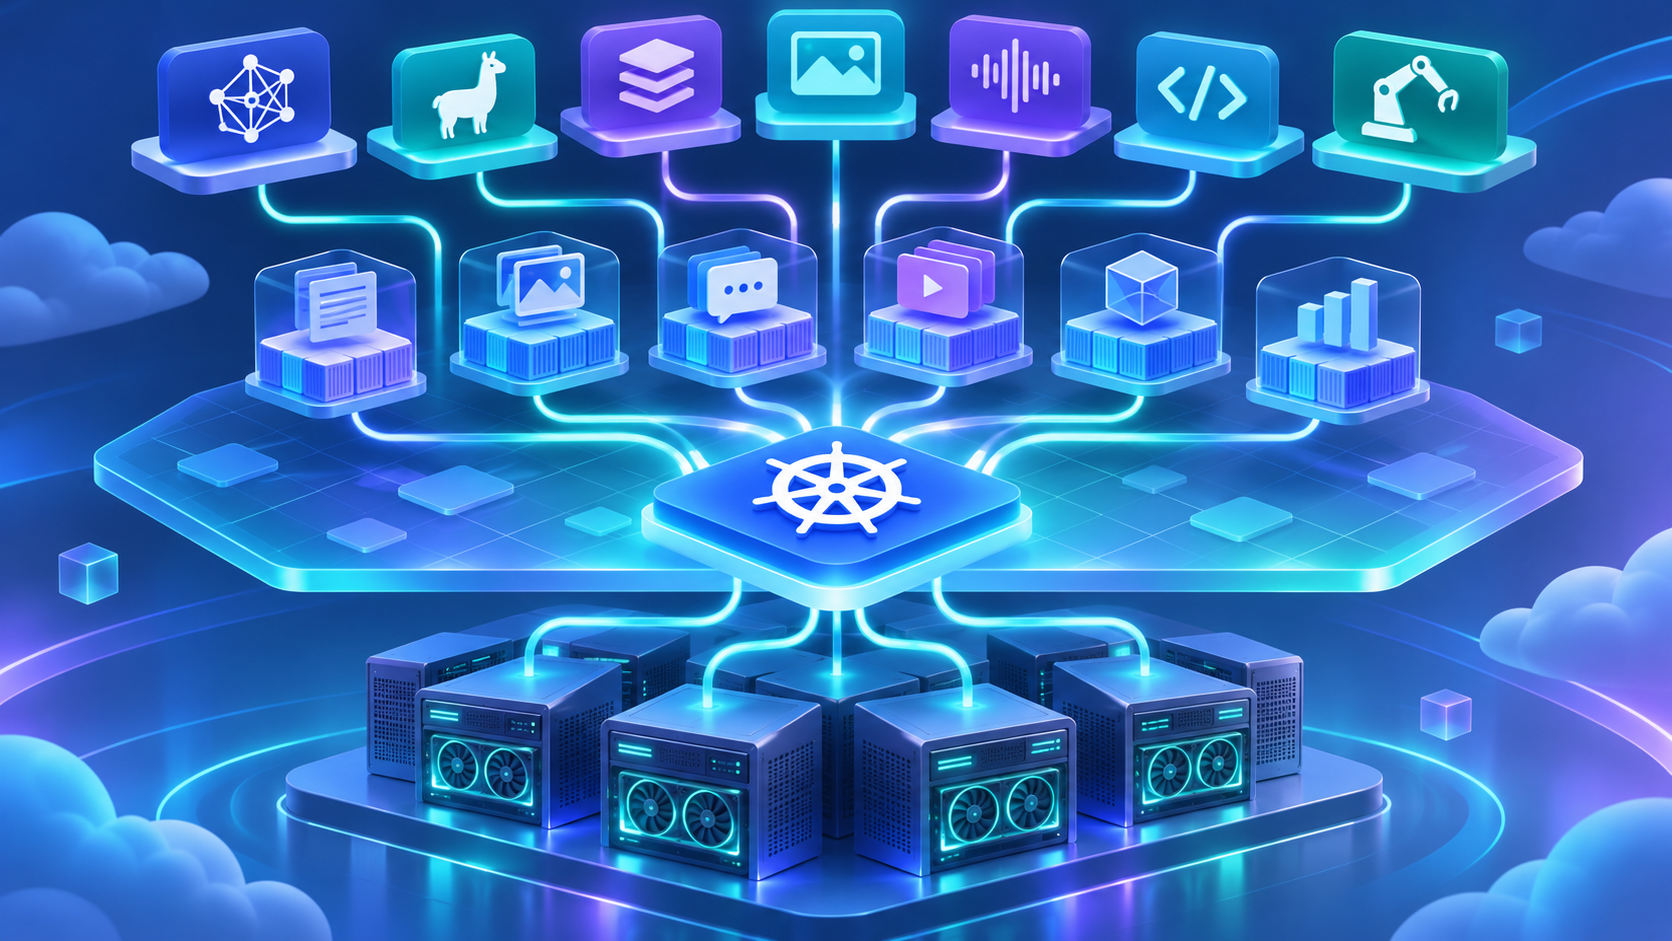
Workload Map cung cấp lớp mô tả chung để scheduler và nền tảng quản lý hiểu nhiều loại tác vụ AI trên Kubernetes.
 GPU / AI
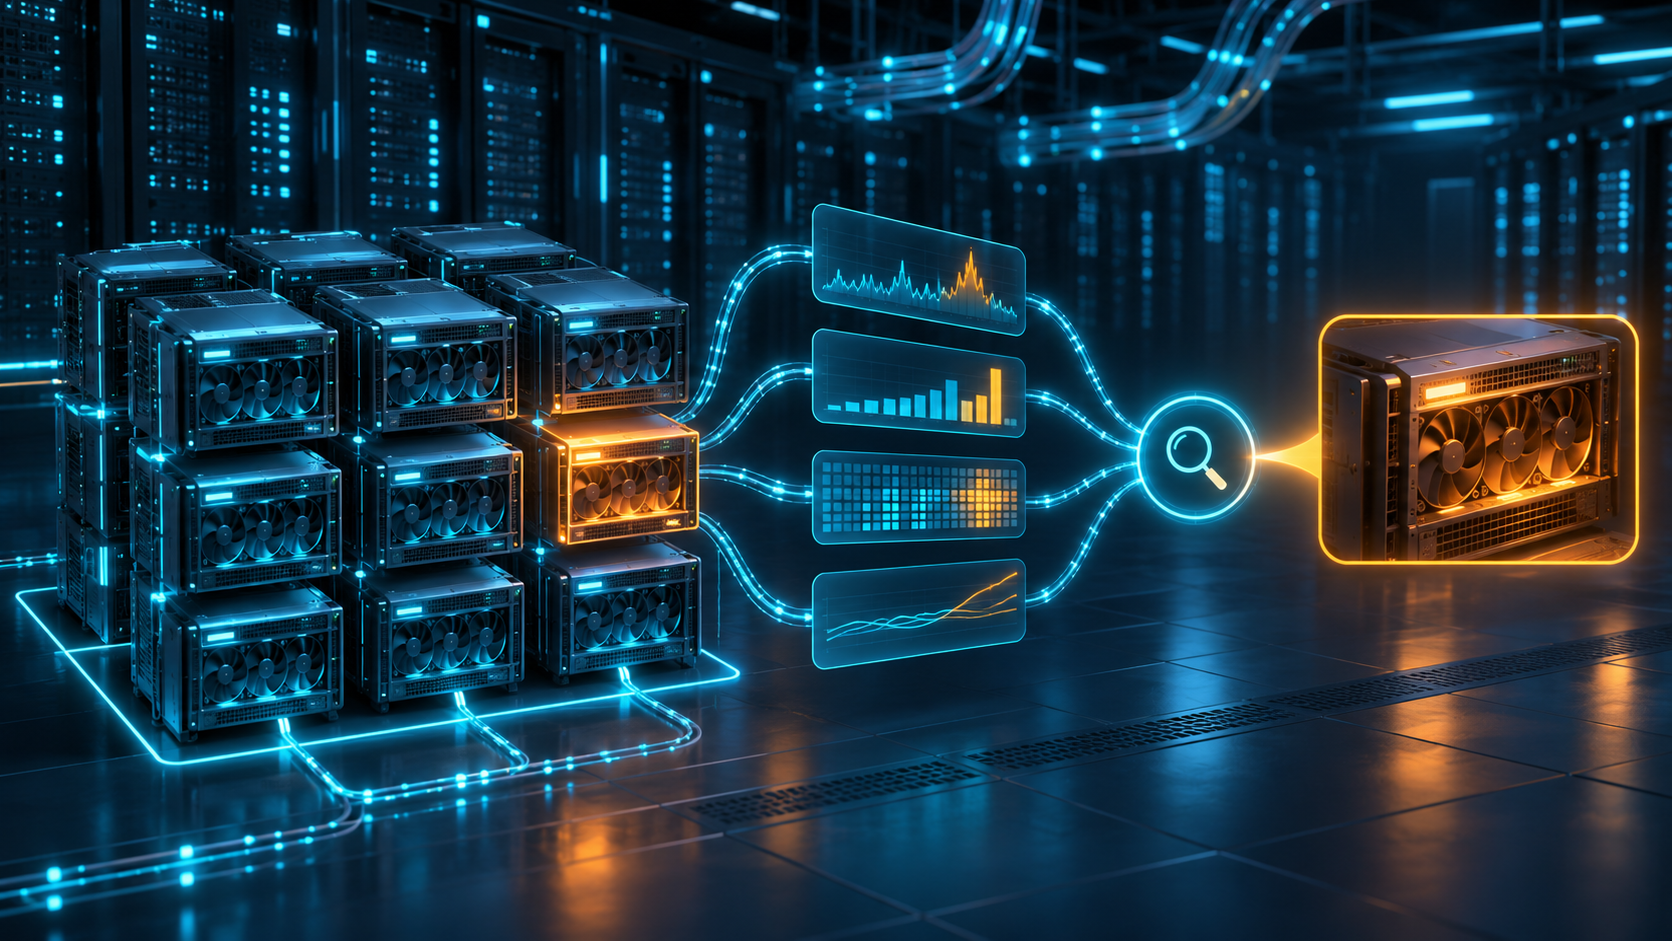
NVIDIA Attribution gom bằng chứng theo từng tác vụ để phân biệt lỗi gốc với chuỗi lỗi NCCL, GPU và mạng phát sinh sau đó.
 GPU / AI
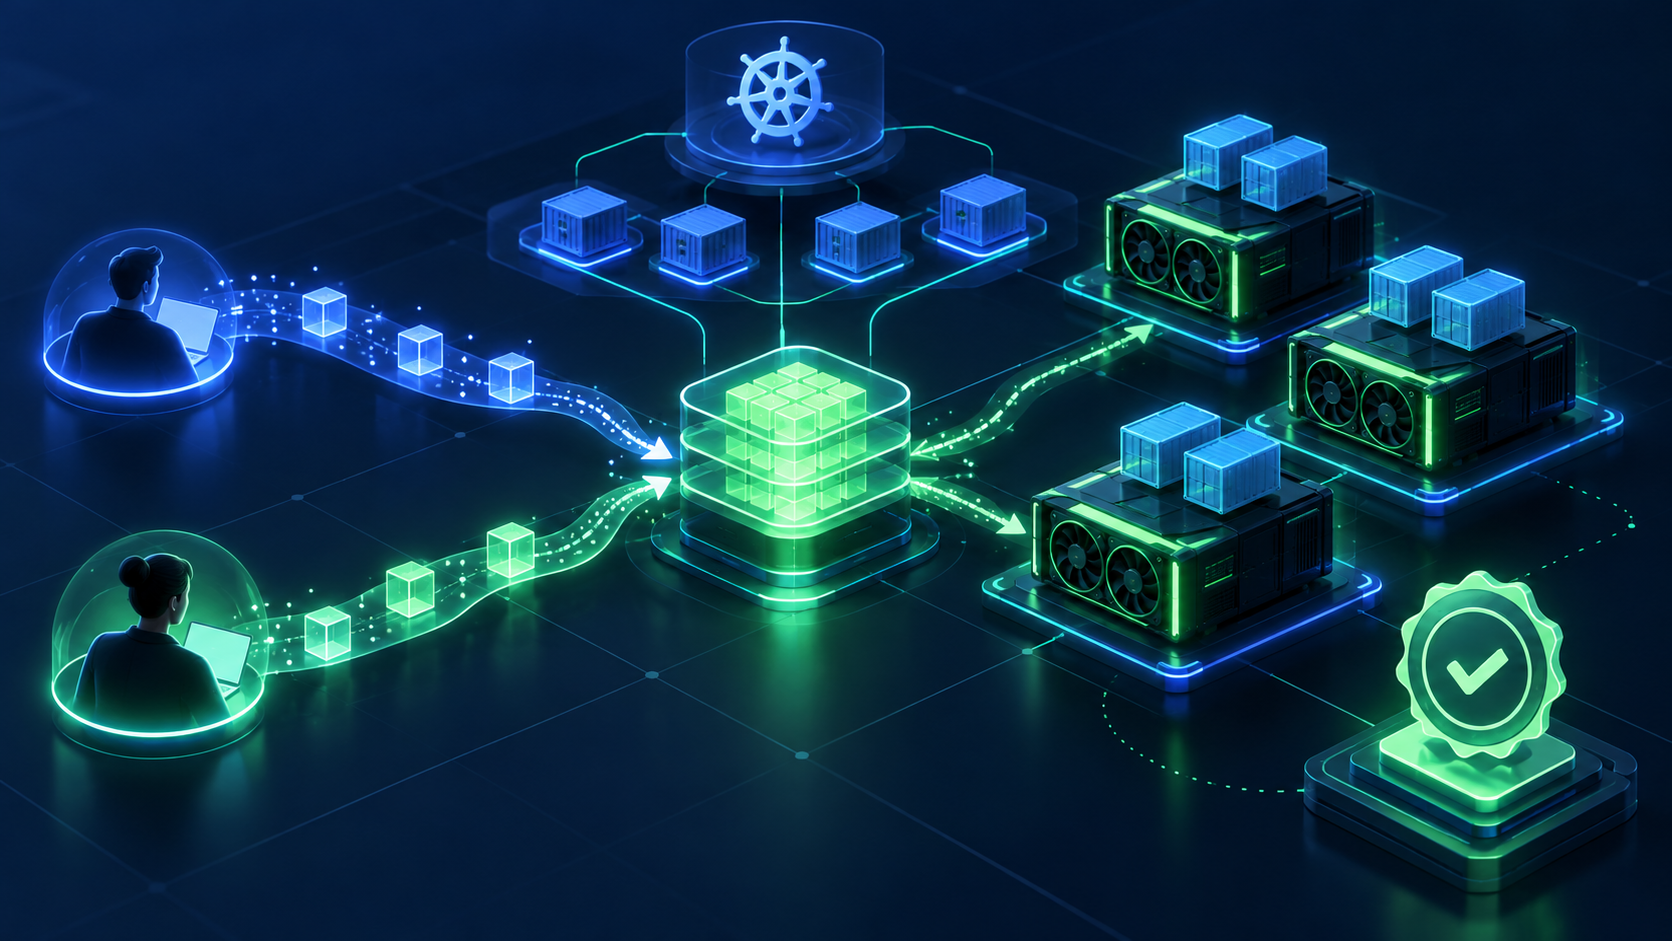
NVIDIA công bố công thức AICR cho Dynamo ngày 30/10/2026, đóng gói GPU Operator, DRA, KAI Scheduler, Grove và giám sát. Đây là hướng chuẩn hóa cụm inference, không phải nút cài đặt thay thế vận hành.
 GPU / AI
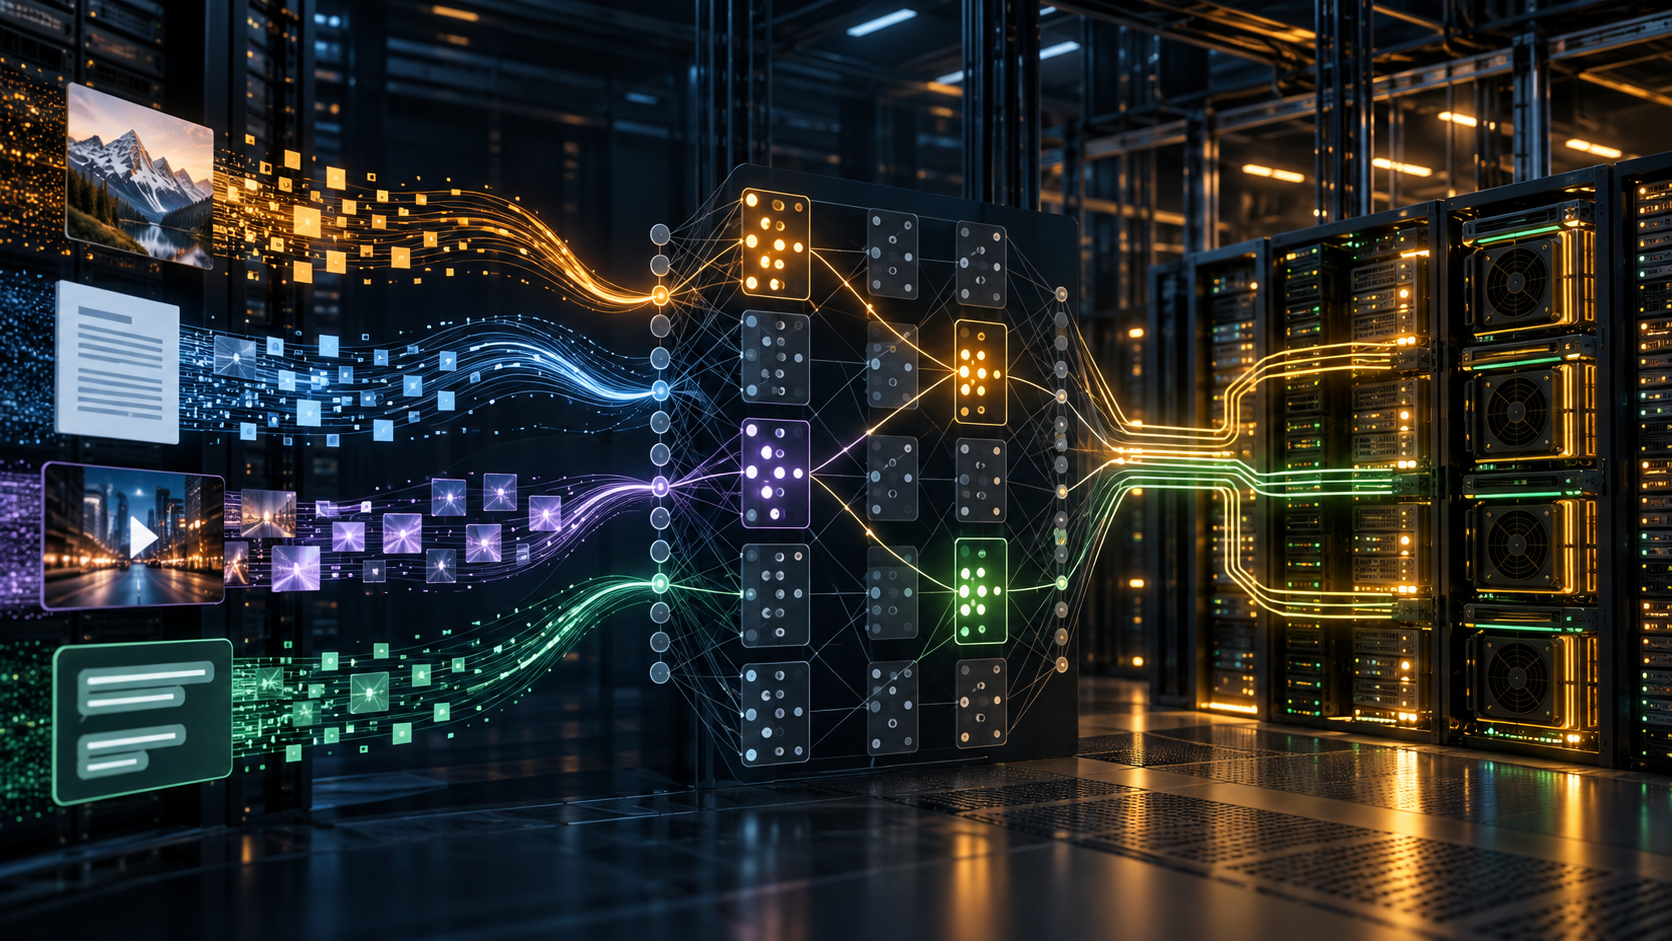
AWS công bố hướng dẫn triển khai Nemotron 3.5 Super VL ngày 29/10/2026. Mô hình đa phương thức 120B tham số nhưng chỉ kích hoạt 12B mỗi token, với yêu cầu GPU rất khác giữa BF16 và NVFP4.
 GPU / AI
NVIDIA giới thiệu NemoClaw ngày 30/10/2026 như một bộ khung mở kết nối agent harness, Nemotron, NeMo và OpenShell. Bài viết phân tích giá trị, giới hạn và checklist thử nghiệm cho đội phát triển AI.
 GPU / AI
OCI sẽ là hyperscaler đầu tiên ngoài Google cung cấp TPU, dự kiến từ năm 2027. Doanh nghiệp cần phân biệt kế hoạch với dịch vụ đã sẵn sàng và đo lại workload.
 GPU / AI
Copilot harness của Microsoft và GitHub đã có trên Foundry ở public preview. Đội phát triển cần đo chất lượng, chi phí, sandbox và khả năng chuyển mô hình.
 GPU / AI
Oracle và NVIDIA đưa Vera Rubin NVL72 cùng Vera CPU lên OCI. Bài viết tách rõ phần đã sẵn sàng, lộ trình và các bước đánh giá trước khi chọn hạ tầng AI.
 GPU / AI
NVIDIA kết hợp Humming, lượng tử hóa FP8 và speculative decoding để tăng tốc Ling-3.0-flash trên DGX Spark. Các con số là benchmark hãng và cần được đo lại.
 GPU / AI
NVIDIA bổ sung cơ chế giới hạn bộ nhớ khi chia sẻ GPU, kết hợp GPU Fractioning Operator và KAI Scheduler. Bài dành cho đội nền tảng muốn tăng mức sử dụng GPU nhưng vẫn kiểm soát tài nguyên.
 GPU / AI
Mission Control 2.5 phối hợp bộ lập lịch, phục hồi job và chẩn đoán phần cứng để giảm thời gian gián đoạn cho cụm GPU Kubernetes.
 GPU / AI
Minerva dùng đồ thị quan hệ và mô hình học máy để liên kết sự cố với workload GPU. Bài viết giúp đội vận hành đọc đúng số liệu hãng và lập kế hoạch thử nghiệm.
 GPU / AI
NVIDIA công bố ngày 23/10/2026 cách Global Performance Tuner trong TensorRT 11.1 thử nhiều lộ trình biên dịch, loại phương án không đạt độ chính xác và chọn engine nhanh nhất trong phép đo.
 GPU / AI
Bài kỹ thuật NVIDIA ngày 22/10/2026 giải thích KvikIO, cuFile và cách xác nhận dữ liệu thực sự đi qua đường GPUDirect Storage thay vì CPU.
 GPU / AI
NVIDIA công bố ngày 22/10/2026 rằng tám DGX Spark có thể ghép thành cụm 1TB bộ nhớ hợp nhất. Các con số hiệu năng là benchmark của hãng.
 GPU / AI
NVIDIA giới thiệu kiến trúc tham chiếu OpenShell ngày 21/10/2026. Bài viết giải thích cách cô lập AI Agent, quản lý khóa truy cập và thử nghiệm trước khi triển khai.
 GPU / AI
Google Cloud công bố Confidential G4 GA ngày 21/10/2026 tại 36 zone. Bài viết giải thích dữ liệu đang xử lý được bảo vệ thế nào và cách kiểm chứng hiệu năng.
 GPU / AI
Ngày 21/10/2026, Google Cloud công bố đưa các mô hình OpenAI vào Model Garden. Hiện là private preview, nên doanh nghiệp cần tách rõ khả năng sẵn có và lộ trình.
 GPU / AI
AWS giới thiệu TorchNeuron ở trạng thái public beta cho Trainium2 và Trainium3. Bài viết giải thích thay đổi với nhà phát triển PyTorch và cách kiểm thử tính đúng, hiệu năng, vận hành.
 GPU / AI
Google công bố llm-d 1.0, ngăn xếp mã nguồn mở để phân phối suy luận LLM trên Kubernetes. Bài viết phân tích tính năng, số liệu do hãng công bố và khi nào kiến trúc này đáng dùng.
 GPU / AI
Ba kernel forward pass của Mamba-2 viết bằng NVIDIA cuTile đạt mức tăng 1,14–1,82 lần so với bản Triton trong phép đo hãng. Bài giúp kỹ sư GPU hiểu đúng phạm vi và thiết kế bài thử thực tế.
 GPU / AI
Cloudflare cho biết chi phí trung bình của hệ thống AI code reviewer giảm từ 2,43 USD xuống 0,77 USD sau tối ưu. Giá trị lớn nhất với đội AI là phương pháp đo, phân tầng và cắt token, không phải con số áp dụng cho mọi hệ thống.
 GPU / AI
NVIDIA Nemotron 3.5 Bolt 74B-A9B được thiết kế để bản lượng tử hóa chạy trong 24GB bộ nhớ. Bài viết giúp đội AI phân biệt khả năng nạp mô hình với hiệu năng thực tế, đọc đúng benchmark của hãng và xây dựng bài thử trước khi chọn GPU.
 GPU / AI
RTX 5070 Ti có 16 GB và thuộc nhóm GeForce Blackwell. Với dự án AI nhỏ, câu hỏi cần trả lời là công việc có vừa VRAM và hoàn thành đúng thời gian yêu cầu hay không.
 GPU / AI
RTX 5060 Ti có bản 8 GB và 16 GB, nên cùng tên card có thể dẫn tới hai trải nghiệm AI rất khác nhau. Với mô hình vừa sát dung lượng, bản 16 GB thường là lựa chọn cần khảo sát trước.
 GPU / AI
L40 có 48 GB cho máy chủ đồ họa, video và AI. Nó khác L40S: cùng dung lượng không có nghĩa cùng năng lực Tensor hay cùng lựa chọn tối ưu cho chatbot.
 GPU / AI
RTX 5080 thuộc GeForce Blackwell nhưng chỉ có 16 GB. Nó phù hợp để khảo sát xử lý nhanh mô hình vừa bộ nhớ, không giải quyết bài toán mô hình cần 24–32 GB chỉ nhờ đời mới.
 GPU / AI
H200 NVL đưa 141 GB HBM3e trên mỗi GPU vào cấu hình PCIe. Đội phục vụ mô hình lớn có thể hưởng lợi từ dư địa bộ nhớ, nhưng vẫn phải đo độ trễ và tải đồng thời.
 GPU / AI
NVIDIA L4 mang 24 GB vào GPU máy chủ nhỏ, đáng khảo sát cho AI và video. Đội làm camera cần xem cả giải mã video, vì tải không chỉ nằm ở mạng AI.
 GPU / AI
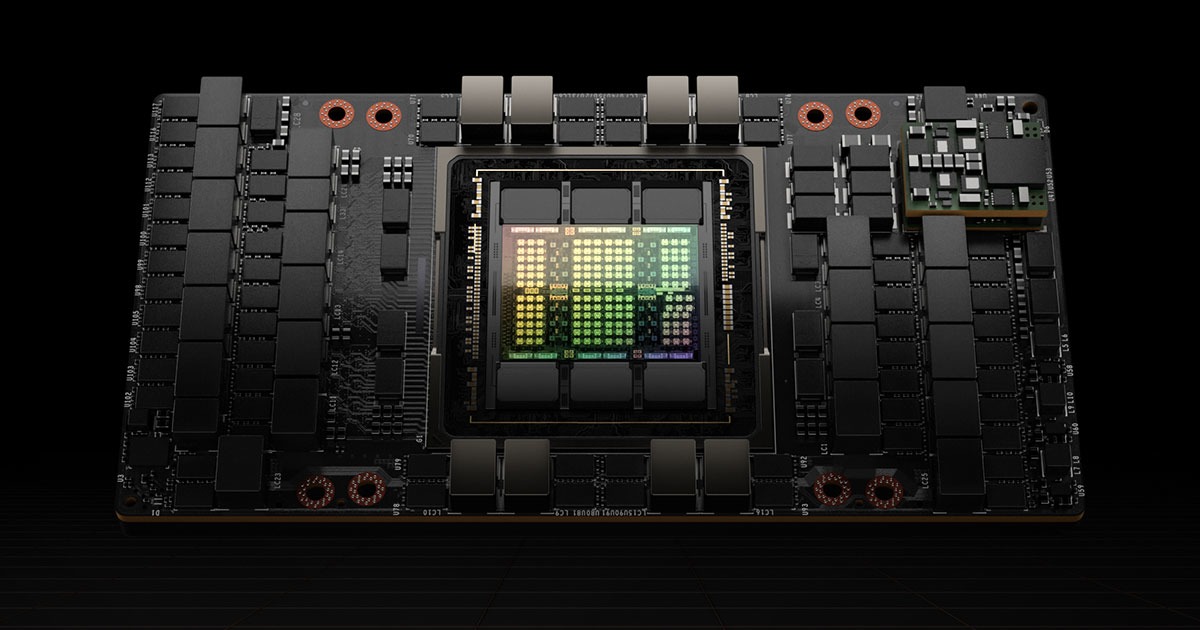
H100 PCIe và H100 NVL cần được đọc tách khỏi H100 SXM. Nhóm muốn triển khai Hopper trong máy chủ PCIe phải ghi đúng phiên bản, dung lượng và cấu hình kết nối.
 GPU / AI
A2 là GPU suy luận AI nhỏ cho hệ thống ít điện và không gian. Nhóm camera, thiết bị tại chi nhánh hoặc máy chủ nhẹ có thể khảo sát trước khi dùng card lớn hơn.
 GPU / AI
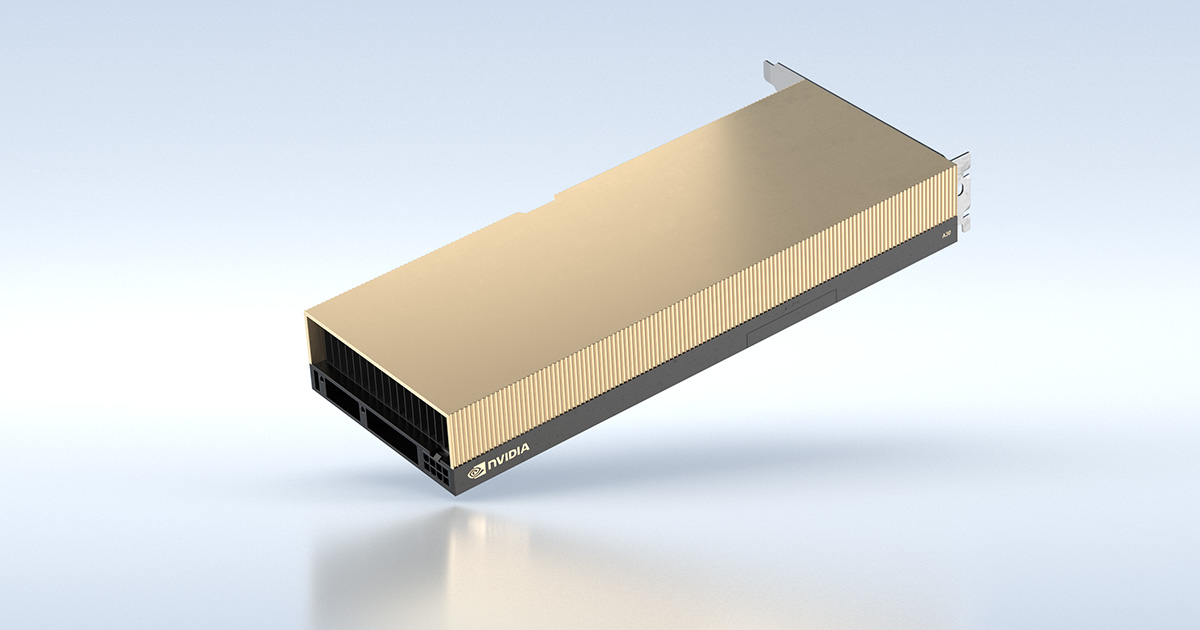
A30 có 24 GB HBM2 cho máy chủ AI và tính toán. Nó khác A10 24 GB ở loại bộ nhớ và định hướng tính toán, nên không thể so chỉ bằng dung lượng.
 GPU / AI
NVIDIA A40 có 48 GB cho hạ tầng kết hợp AI và đồ họa. Nó đáng khảo sát khi mô hình vượt 24 GB, nhưng không nên đánh đồng với A100 vì đều thuộc Ampere.
 GPU / AI
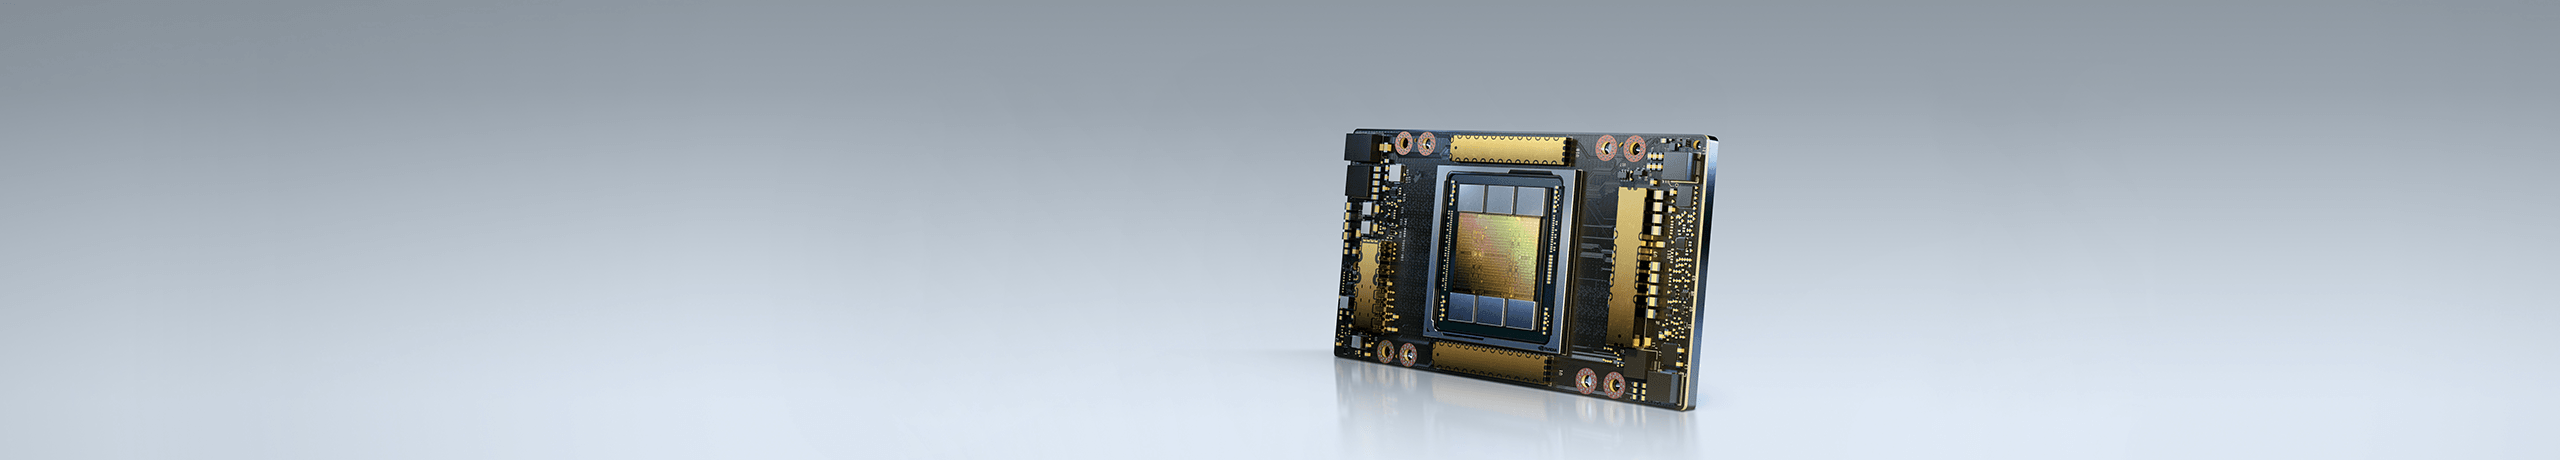
A100 có cả bản 40 GB và 80 GB, đồng thời có dạng PCIe và SXM. Một báo giá chỉ ghi A100 là chưa đủ để tính bộ nhớ, điện hoặc cấu hình kết nối.
 GPU / AI
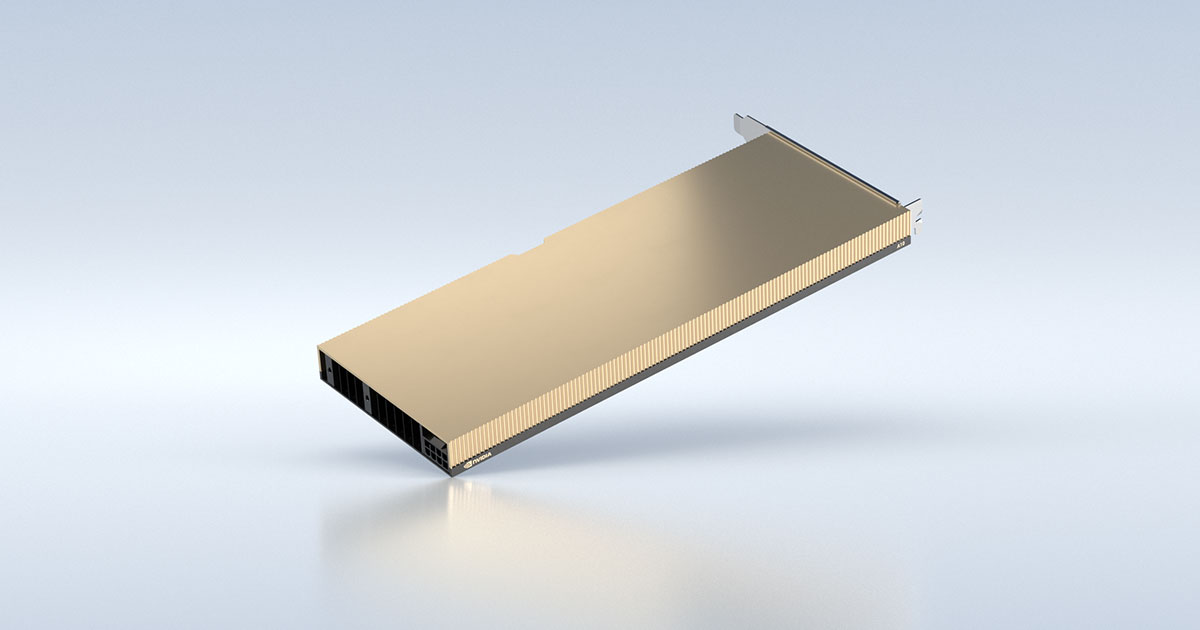
NVIDIA A10 là card máy chủ 24 GB một khe, phù hợp để khảo sát AI và ứng dụng đồ họa trên cùng hạ tầng. A10 không phải RTX A4000 hay một tên chung cho card Ampere.
 GPU / AI
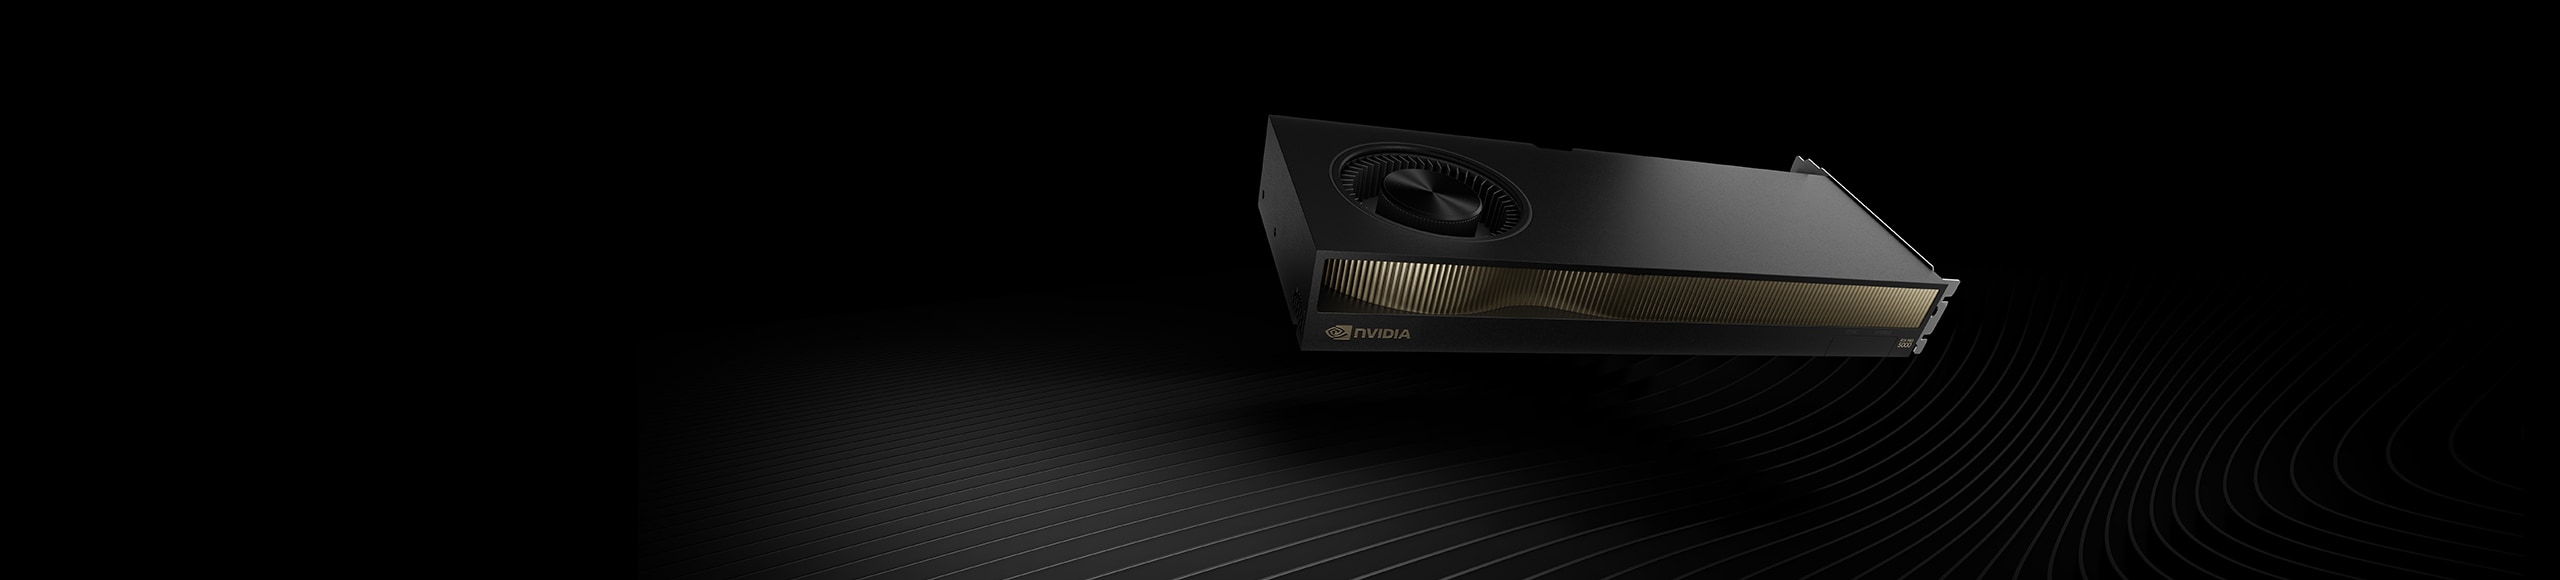
RTX PRO 5000 Blackwell hiện có hai bản 48 GB và 72 GB. Đây là khác biệt lớn với đội thường phải đẩy một phần mô hình sang RAM vì card 32–48 GB không đủ.
 GPU / AI
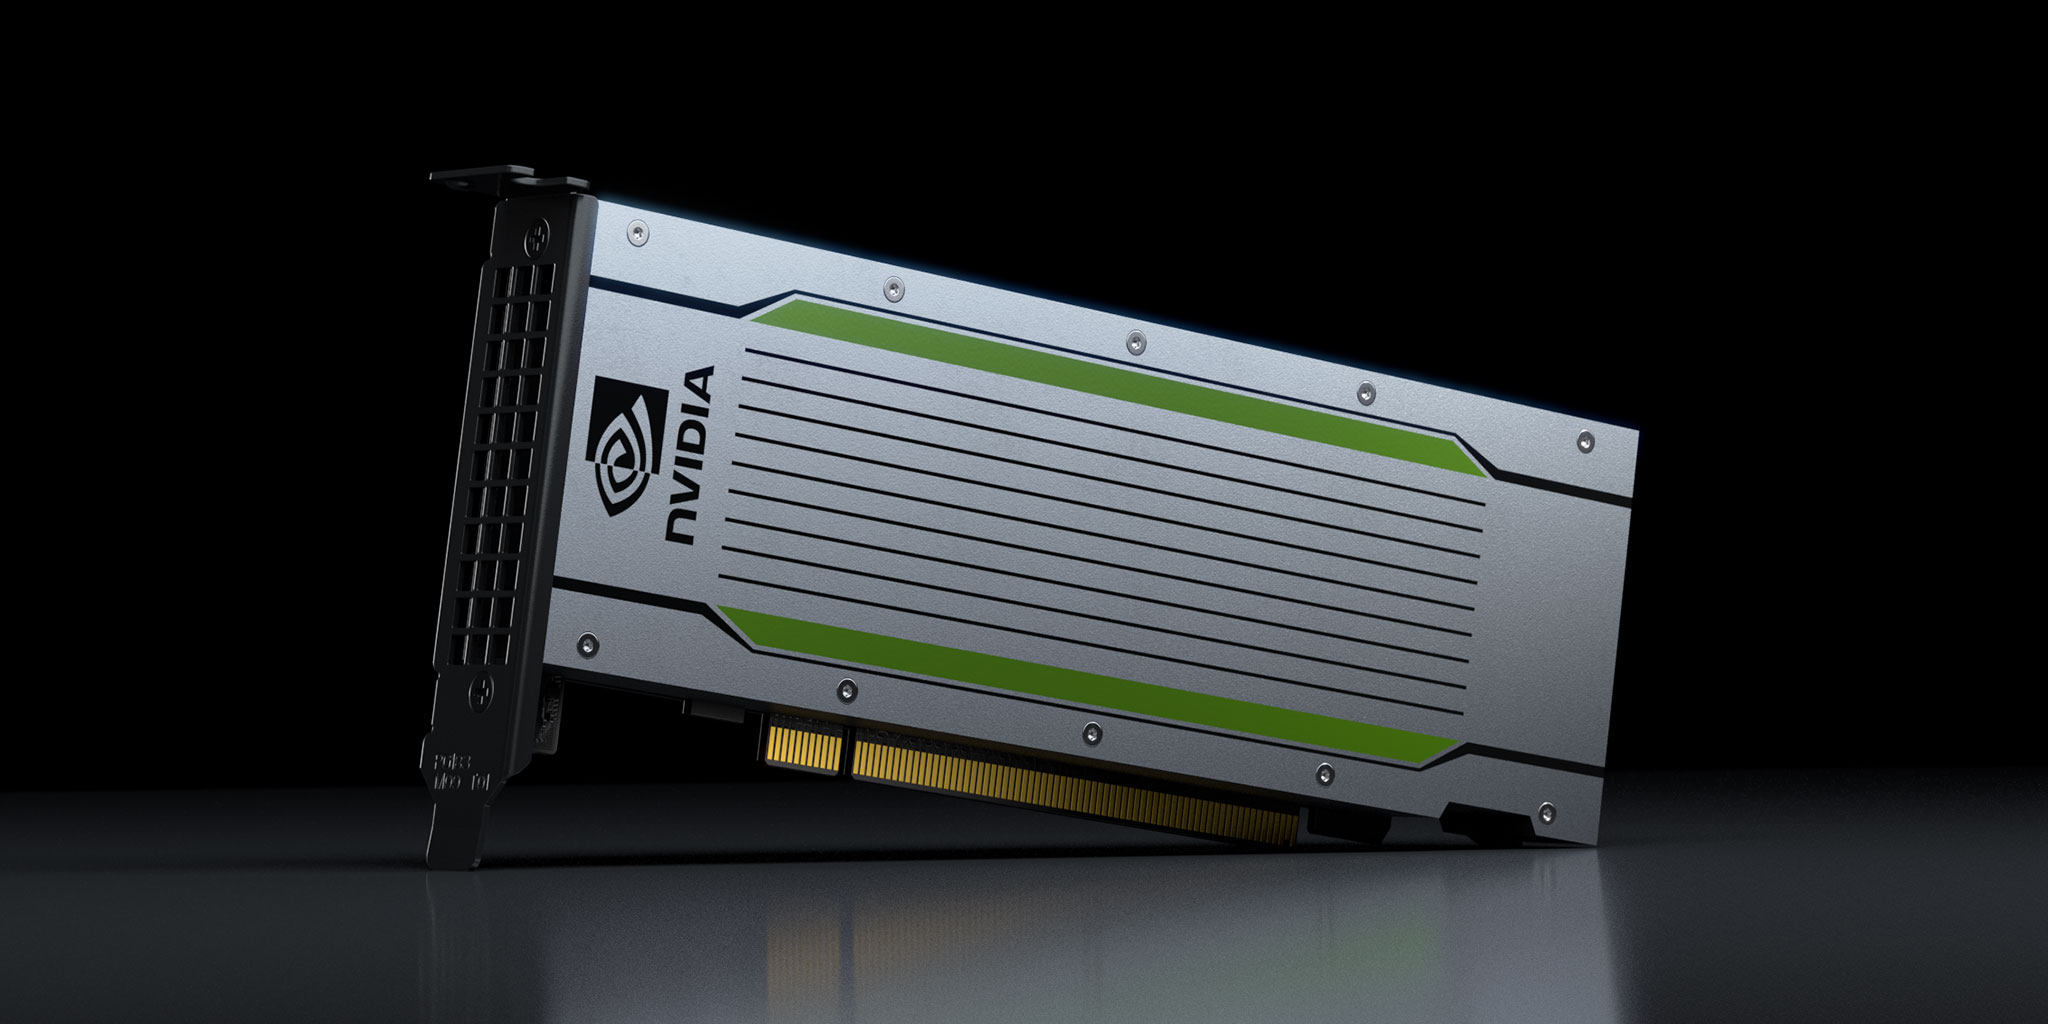
NVIDIA T4 vẫn xuất hiện trong nhiều máy chủ suy luận AI nhờ card nhỏ và mức điện thấp. Đây là GPU Turing đời cũ, nên phải xem cả môi trường phần mềm khi so với thế hệ mới.
 GPU / AI
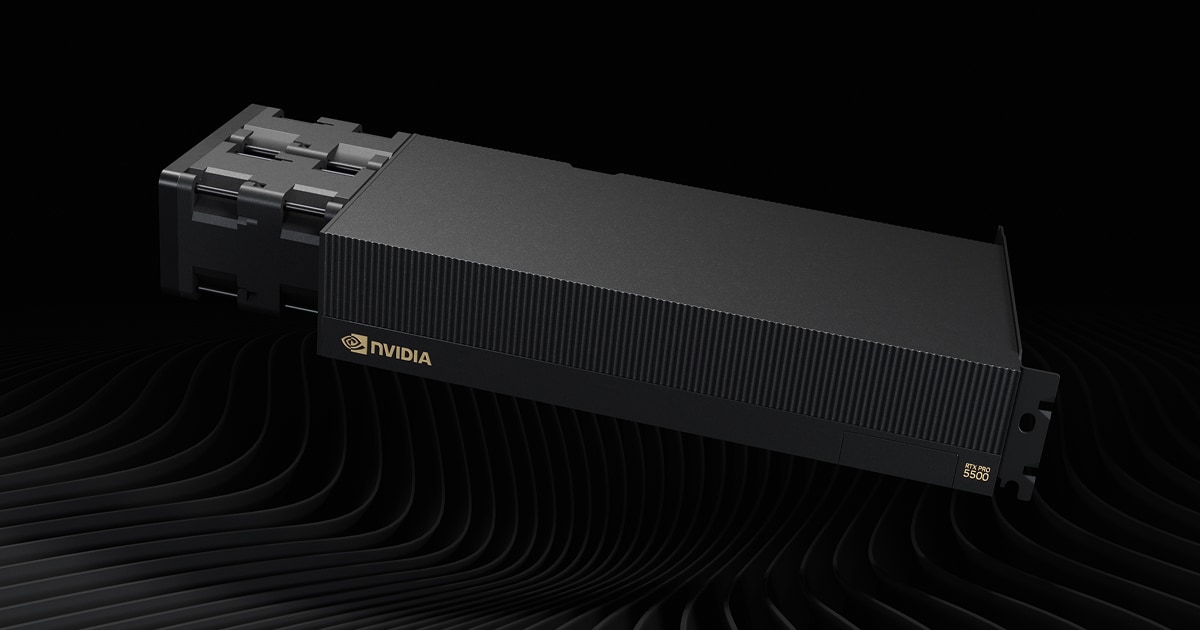
RTX PRO 5500 Blackwell Workstation được NVIDIA giới thiệu với 84 GB cho máy trạm đặt trong rack. Tại thời điểm kiểm tra 09/10/2026, trang hãng vẫn ghi Coming Soon, nên cần tách thông số công bố khỏi khả năng giao hàng.
 GPU / AI
RTX PRO 6000 Blackwell có bản Workstation và Max-Q cùng 96 GB nhưng khác mức điện. Chọn đúng bản ảnh hưởng cả thiết kế máy lẫn thời gian hoàn thành công việc.
 GPU / AI
V100 là GPU Volta vẫn gặp trong cụm nghiên cứu và máy chủ đã đầu tư từ trước. Nó có thể hữu ích để chạy lại dự án cũ, nhưng không nên chọn chỉ vì tên Tesla quen thuộc.
 GPU / AI
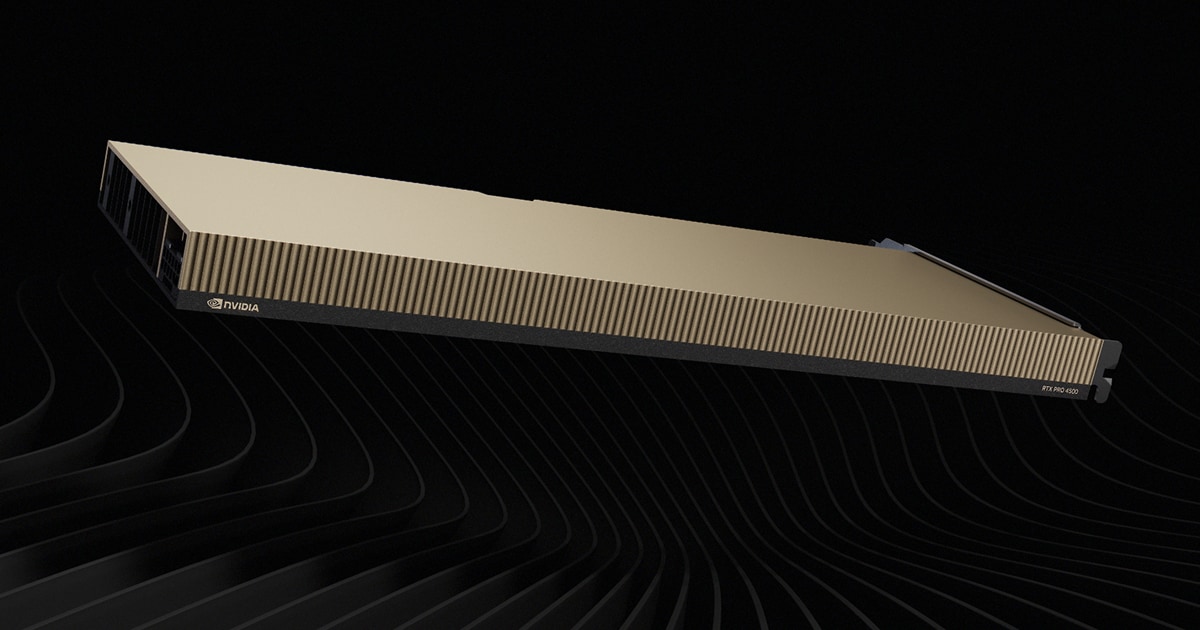
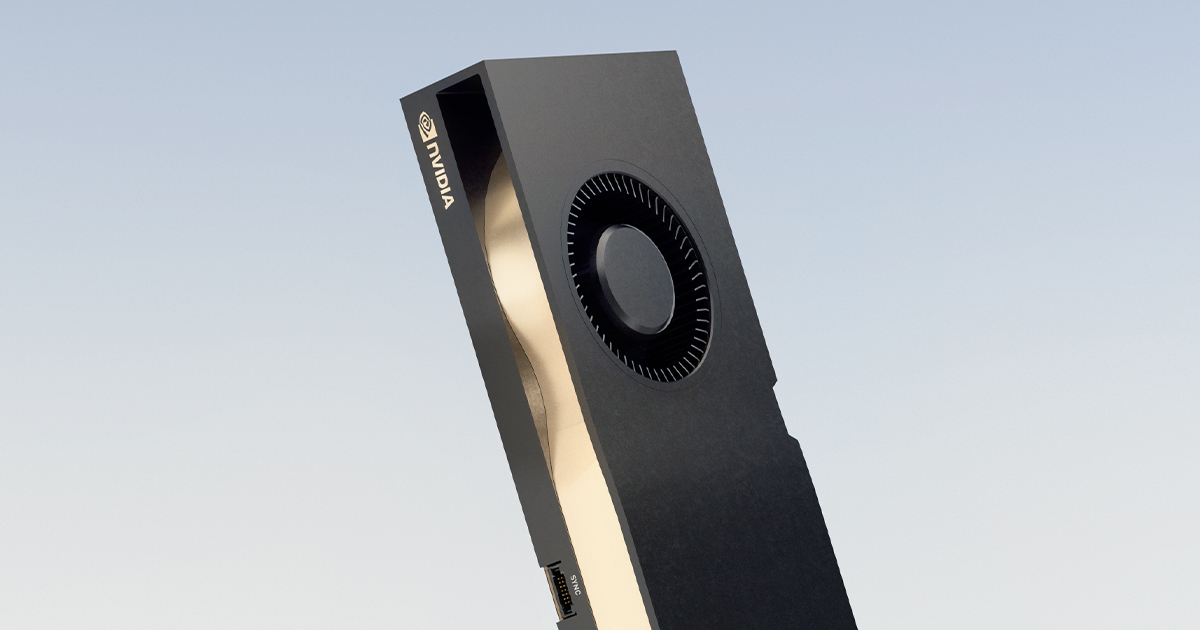
RTX PRO 4500 Blackwell Server mang 32 GB vào card một khe 165 W cho máy chủ. Nhóm nên cân nhắc là đội triển khai thị giác, video hoặc chatbot vừa phải trên hạ tầng tập trung.
 GPU / AI
RTX PRO 4000 Blackwell nâng nhóm card một khe lên 24 GB. Nó phù hợp để khảo sát khi máy trạm cần AI, thiết kế và xử lý video nhưng vẫn phải giữ chỗ cho card khác.
 GPU / AI
RTX PRO 2000 Blackwell có 16 GB trong card nhỏ 70 W, phù hợp cho đội muốn thử thế hệ mới nhưng không cần nâng cả nguồn máy. Dung lượng vẫn đặt giới hạn rõ cho chatbot lớn.
 GPU / AI
RTX PRO 4000 Blackwell SFF có 24 GB ở mức 70 W, đáng chú ý với máy trạm nhỏ. Lợi thế là chứa thêm dữ liệu trong không gian hạn chế, không phải thay thế GPU data center cao cấp.
 GPU / AI
RTX PRO 4500 Blackwell Workstation có 32 GB, dành cho đội cần cả AI và phần mềm đồ họa trên máy trạm. Đừng dùng thông số của bản Server khi đặt mua bản này.
 GPU / AI
RTX 2000 Ada đưa 16 GB vào nhóm card máy trạm nhỏ dùng mức điện 70 W. Đây là lựa chọn đáng thử cho trợ lý cá nhân hoặc phần mềm thiết kế có thêm chức năng AI.
 GPU / AI
RTX 5000 Ada có 32 GB, tạo khoảng trống cho các dự án vượt nhóm 24 GB nhưng chưa cần 48 GB. Đây là bước tăng dung lượng, không phải bảo đảm chạy mọi mô hình 32B.
 GPU / AI
RTX 4000 SFF Ada dành cho máy trạm nhỏ cần nhiều bộ nhớ nhưng hạn chế điện và không gian. SFF là Small Form Factor, nghĩa là kích thước nhỏ, không phải một chuẩn hiệu năng AI.
 GPU / AI
RTX 4500 Ada là GPU 24 GB dành cho nhóm vừa làm AI vừa dùng ứng dụng chuyên nghiệp. Nó đáng thử khi mô hình vừa 24 GB và cần một máy trạm đáp ứng nhiều công việc.
 GPU / AI
RTX 4000 Ada có 20 GB trong thiết kế một khe, phù hợp khi máy trạm phải dành chỗ cho nhiều phần cứng. Với AI, nó tạo thêm dư địa so nhóm 16 GB nhưng chưa thay được card 32–48 GB.
 GPU / AI
RTX A5500 cũng có 24 GB như A5000, vì vậy nâng cấp giữa hai card không giải quyết bài toán mô hình vượt 24 GB. Nó đáng xem xét khi cần tăng năng lực xử lý trong cùng nhóm bộ nhớ.
 GPU / AI
Nếu đang cần một card chuyên nghiệp 16 GB nhưng máy chỉ còn một khe mở rộng, RTX A4000 đáng đưa vào danh sách thử. Giới hạn đầu tiên của chatbot trên card này thường là bộ nhớ khi tăng số người dùng.
 GPU / AI
Máy nhỏ, nguồn điện hạn chế và nhu cầu thử AI là ba lý do để cân nhắc RTX A2000. Với card này, chọn đúng bản 6 GB hay 12 GB quan trọng hơn việc nhìn tên A2000 trên báo giá.
 GPU / AI
RTX A5000 phù hợp khi đội kỹ thuật muốn dùng một GPU chuyên nghiệp 24 GB cho cả AI lẫn thiết kế. Nó không phải GeForce RTX 5000 và cũng không phải RTX 5000 Ada.
 GPU / AI
RTX A4500 nằm giữa nhóm 16 GB và 24 GB, hữu ích khi công việc hơi vượt bộ nhớ A4000 nhưng ngân sách chưa cần card 48 GB. Trước khi thuê, hãy chạy đúng dữ liệu đang làm dự án bị hết bộ nhớ.
 GPU / AI
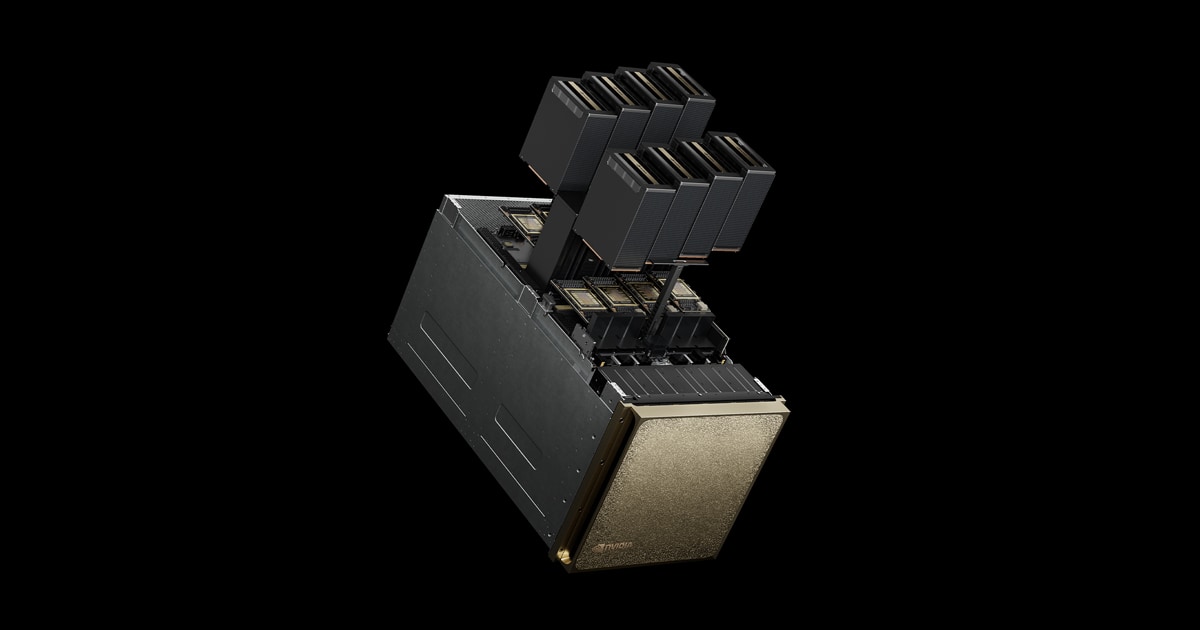
B200 hướng tới nền tảng AI có tải lớn và nhiều GPU. Người thuê cần hiểu một GPU B200, hệ thống HGX/DGX B200 và rack GB200 là các cấp cấu hình khác nhau; tên kiến trúc không thay bảng cấu hình máy.
 GPU / AI
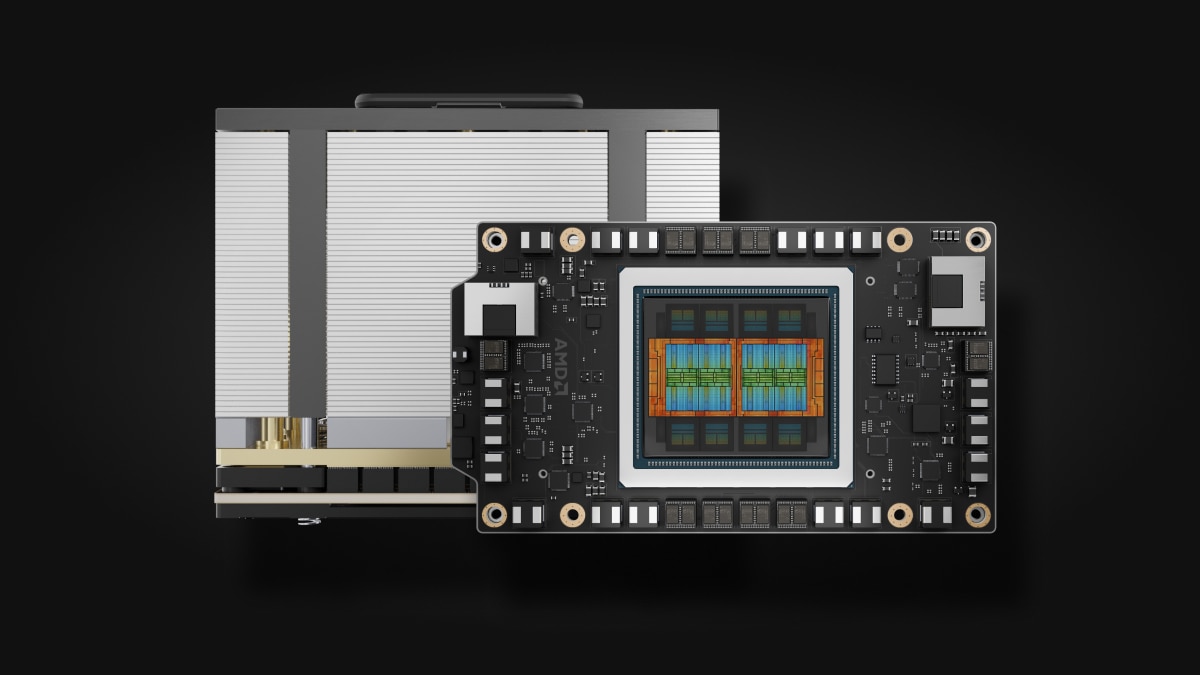
MI350X đáng khảo sát khi mô hình hoặc cache đòi hỏi bộ nhớ lớn và đội kỹ thuật có thể vận hành ROCm. 288 GB là lợi thế về dung lượng trên một GPU, nhưng mã viết riêng cho CUDA không tự chuyển sang AMD.
 GPU / AI
RTX 6000 Ada phù hợp để khảo sát khi dự án cần cả AI và ứng dụng thiết kế, dựng hình. Đừng nhầm với Quadro RTX 6000 đời Turing hoặc RTX PRO 6000 Blackwell: tên gần nhau nhưng dung lượng và thế hệ khác nhau.
 GPU / AI
RTX A6000 vẫn có giá trị khảo sát cho bài toán cần bộ nhớ 48 GB nhưng không nhất thiết cần Tensor Core đời mới nhất. Quyết định thuê nên dựa trên thời gian hoàn thành công việc, không chỉ tuổi kiến trúc.
 GPU / AI
Doanh nghiệp vừa chạy AI vừa xử lý hình ảnh hoặc đồ họa có thể khảo sát L40S. Dung lượng 48 GB mở thêm lựa chọn so với GeForce 24–32 GB, nhưng không tương đương H100 về HBM hay kết nối cụm.
 GPU / AI
H100 SXM phù hợp để khảo sát cho đội AI cần một nền tảng máy chủ có kết nối nhiều GPU và hỗ trợ vận hành doanh nghiệp. Phải ghi đúng SXM: H100 NVL và các bản PCIe không có cùng bộ nhớ hay công suất.
 GPU / AI
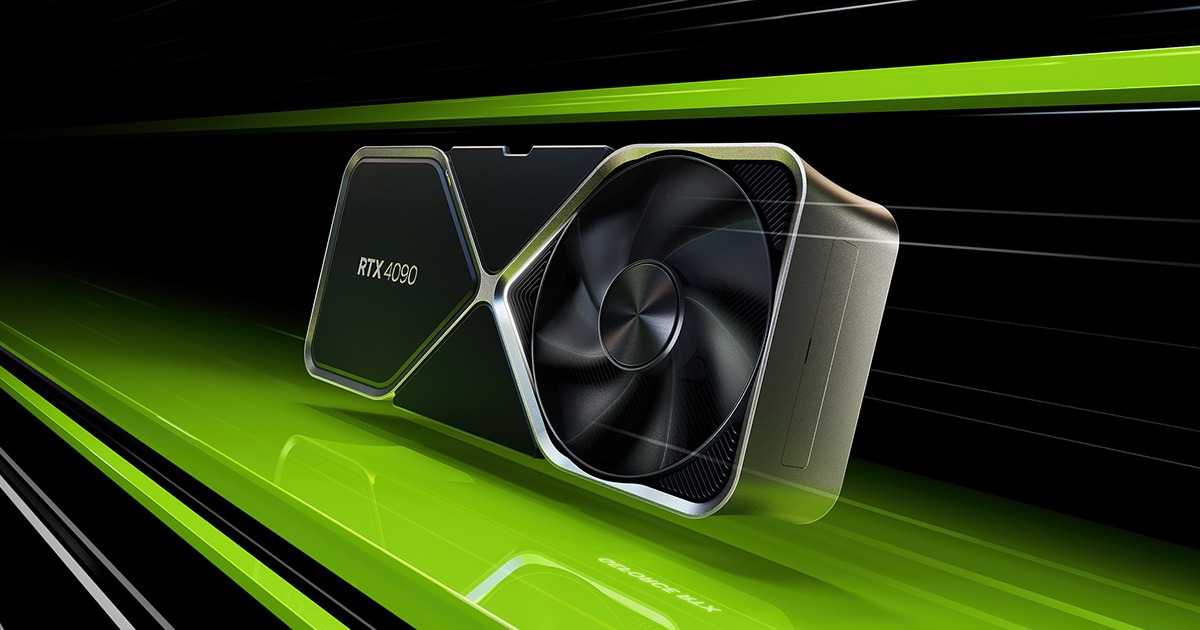
RTX 4090 là lựa chọn cần đánh giá khi công việc vừa trong 24 GB và đội phát triển muốn dùng hệ sinh thái CUDA phổ biến. Giới hạn bộ nhớ vẫn giống RTX 3090, dù năng lực xử lý thuộc thế hệ mới hơn.
 GPU / AI
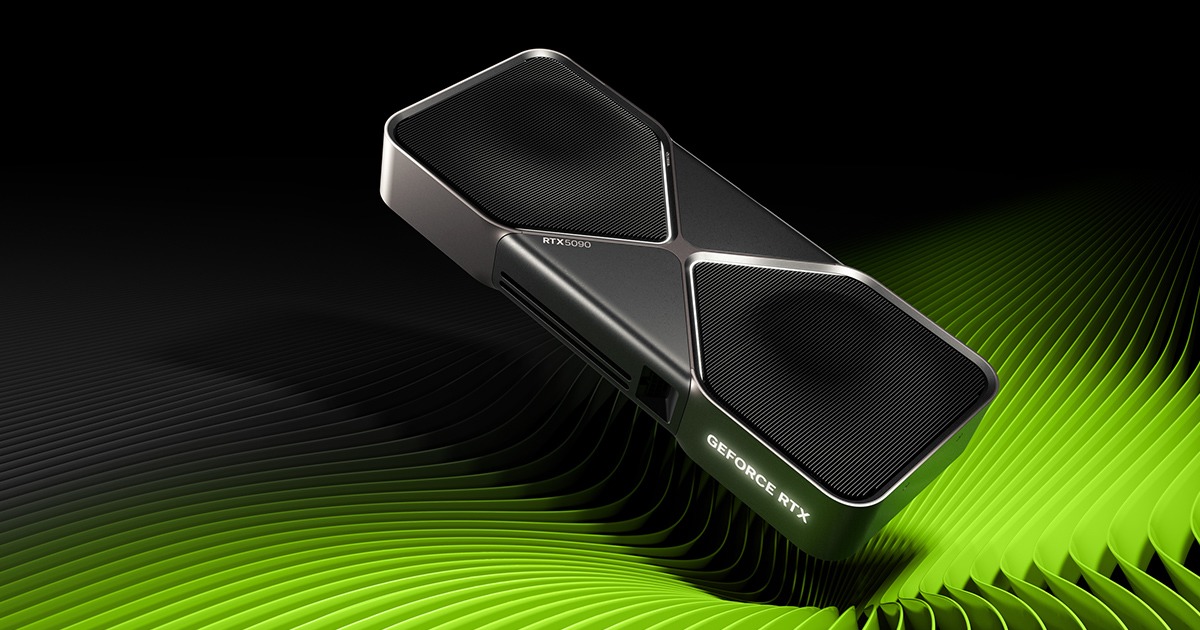
Đội làm chatbot hoặc tạo ảnh cần cân bằng bộ nhớ với giá thuê thường bắt đầu từ GeForce. RTX 5090 có 32 GB, nhưng không phải cứ là thế hệ mới thì sẽ chứa được mô hình 70B.
 GPU / AI
Khi mục tiêu là thử nghiệm mô hình nhỏ hoặc tạo ảnh, RTX 3090 có thể đáng khảo sát nếu tổng chi phí phù hợp. 24 GB giúp linh hoạt hơn card ít bộ nhớ, nhưng tuổi phần cứng và hệ thống làm mát ảnh hưởng vận hành lâu dài.
 GPU / AI
Đội phục vụ mô hình lớn thường hết bộ nhớ trước khi dùng hết tính toán. H200 tăng dư địa chứa trọng số và cache, nên cần đánh giá theo số phiên đồng thời và độ dài tài liệu mà khách gửi vào.
 GPU / AI
Chatbot lỗi dù khách vẫn đăng nhập được? Tìm hiểu thay đổi 401/2009 của Cloudflare AI Gateway và các bước kiểm tra khóa truy cập, giới hạn thử lại, thông báo cho khách.
 GPU / AI
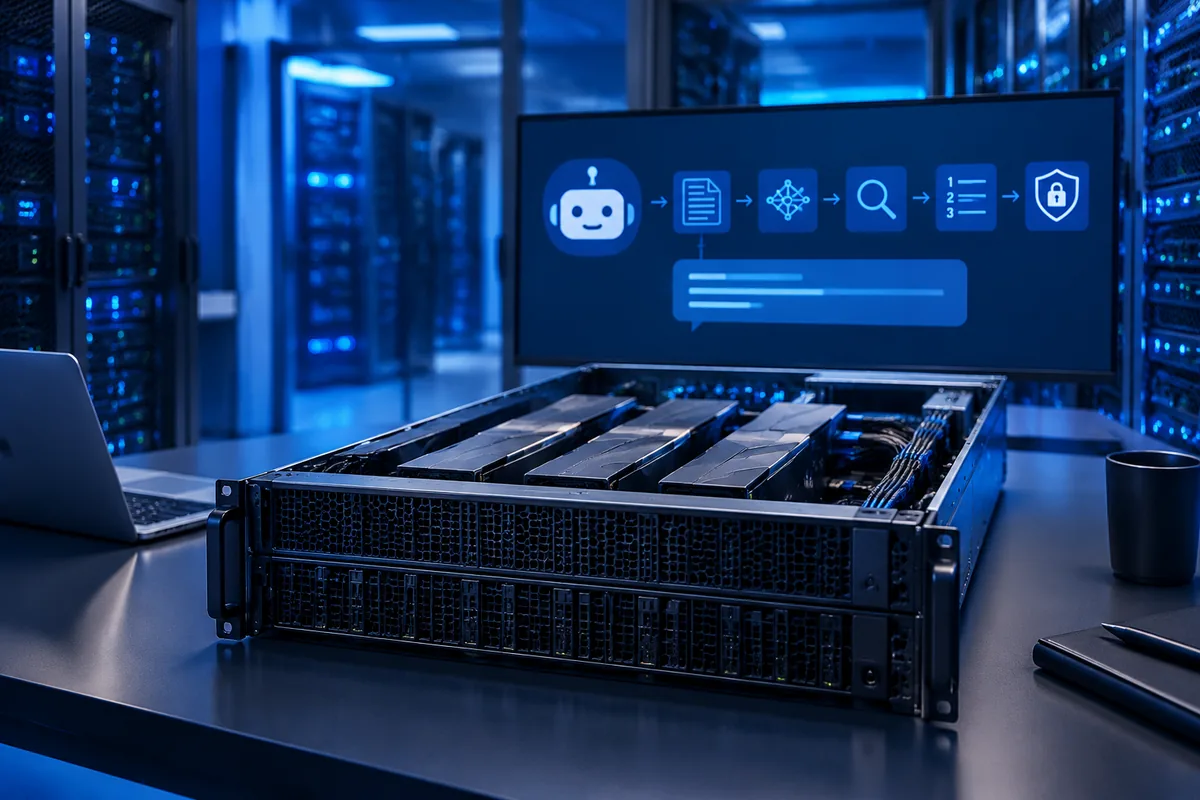
GPU cho chatbot RAG cần được chọn sau khi xác định model và pipeline truy xuất. RAG không chỉ có bước sinh câu trả lời: nạp tài liệu, embedding, tìm kiếm, reranking và kiểm soát quyền đều ảnh hưởng tốc độ cùng chất lượng.
 GPU / AI
NVIDIA Vera Rubin NVL72 là nền tảng AI cấp rack cần được đánh giá cùng mạng, storage và vận hành. Doanh nghiệp quan tâm thế hệ GPU mới nên phân biệt thông số một Rubin GPU với thông số hệ thống hoàn chỉnh, trước khi lập ngân sách hoặc yêu cầu báo giá.
 GPU / AI
Thuê GPU để tự phục vụ model và dùng API AI là hai phương án có cấu trúc chi phí khác nhau. API thường tính theo mức dùng hoặc hợp đồng; GPU có chi phí tài nguyên và đội vận hành, kể cả khi chưa sử dụng hết. Quyết định cần so cả chất lượng đầu ra, độ trễ và dữ liệu.
 GPU / AI
Ứng dụng coding agent có thể đọc repository, lịch sử trao đổi và nhiều tài liệu trước khi sinh câu trả lời. Khi đầu vào dài, thời gian xử lý prompt trở thành một phần quan trọng của trải nghiệm. Rubin CPX là sản phẩm NVIDIA giới thiệu nhằm phục vụ hướng xử lý context rất lớn này.
 GPU / AI
DGX B300 và GB300 NVL72 là hai cách triển khai hạ tầng Blackwell Ultra ở quy mô khác nhau. So sánh chúng chỉ bằng số GPU hoặc con số PFLOPS dễ bỏ qua khả năng tận dụng tài nguyên và chi phí vận hành. Bài này hướng tới người đang chuẩn bị cấu hình AI, không phải bảng giá phần cứng.
 GPU / AI
Dữ liệu trên GPU Server có thể gồm checkpoint tải về, dataset riêng, trọng số tinh chỉnh, cấu hình và kết quả chạy. Khi kết thúc thuê hoặc máy lỗi, mất một artifact nhỏ nhưng không thể tái tạo có thể làm mất nhiều giờ tính toán.
 GPU / AI
Chọn GPU NVIDIA mới nhất cho AI cần bắt đầu từ nhóm sản phẩm và công việc cần chạy. GPU trong máy trạm, GPU data center và một rack AI hoàn chỉnh phục vụ những yêu cầu khác nhau. Bài tổng quan này giúp doanh nghiệp lập danh sách đánh giá mà không đánh đồng tên kiến trúc với một cấu hình có thể thuê ngay.
 GPU / AI
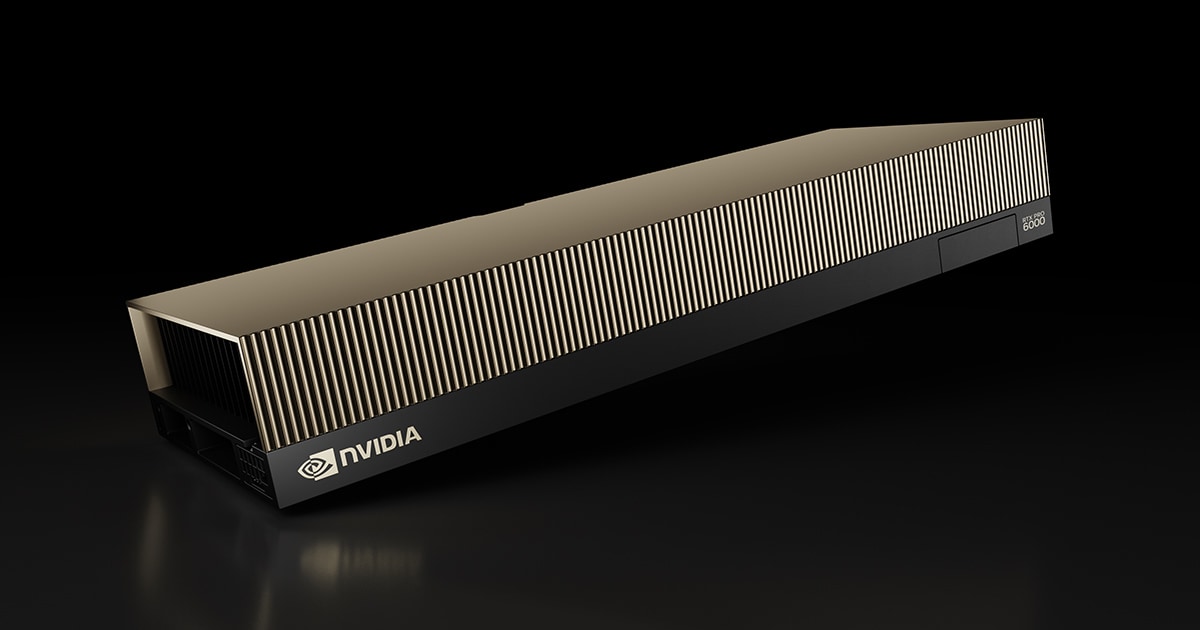
Đội AI cần bộ nhớ lớn cùng xử lý đồ họa hoặc video có thể khảo sát RTX PRO 6000 Blackwell Server Edition. Phải ghi đúng Server Edition vì cùng tên RTX PRO 6000 còn có phiên bản Workstation và Max-Q.
 GPU / AI
Chi phí thuê GPU Server cần gắn với công việc phải hoàn thành và thời gian sử dụng. Một GPU có phí thấp mỗi giờ có thể mất lâu hơn cho cùng job, trong khi thuê theo tháng có thể tốn nhiều nếu card phần lớn nhàn rỗi.
 GPU / AI
Hướng dẫn chọn GPU Server theo workload: bộ nhớ, độ trễ, tải đồng thời và khả năng vận hành ứng dụng AI.
 GPU / AI
So sánh 24 GB GDDR6X và 32 GB GDDR7; chọn GPU theo model, tải đồng thời và kết quả kiểm thử ứng dụng.
 GPU / AI
Tính riêng trọng số, KV cache và overhead; ví dụ context 8K, 32K và 128K với cache FP16.