NVIDIA RTX 6000 Ada: thông số, phiên bản và mô hình AI
RTX 6000 Ada phù hợp để khảo sát khi dự án cần cả AI và ứng dụng thiết kế, dựng hình. Đừng nhầm với Quadro RTX 6000 đời Turing hoặc RTX PRO 6000 Blackwell: tên gần nhau nhưng dung lượng và thế hệ khác nhau.
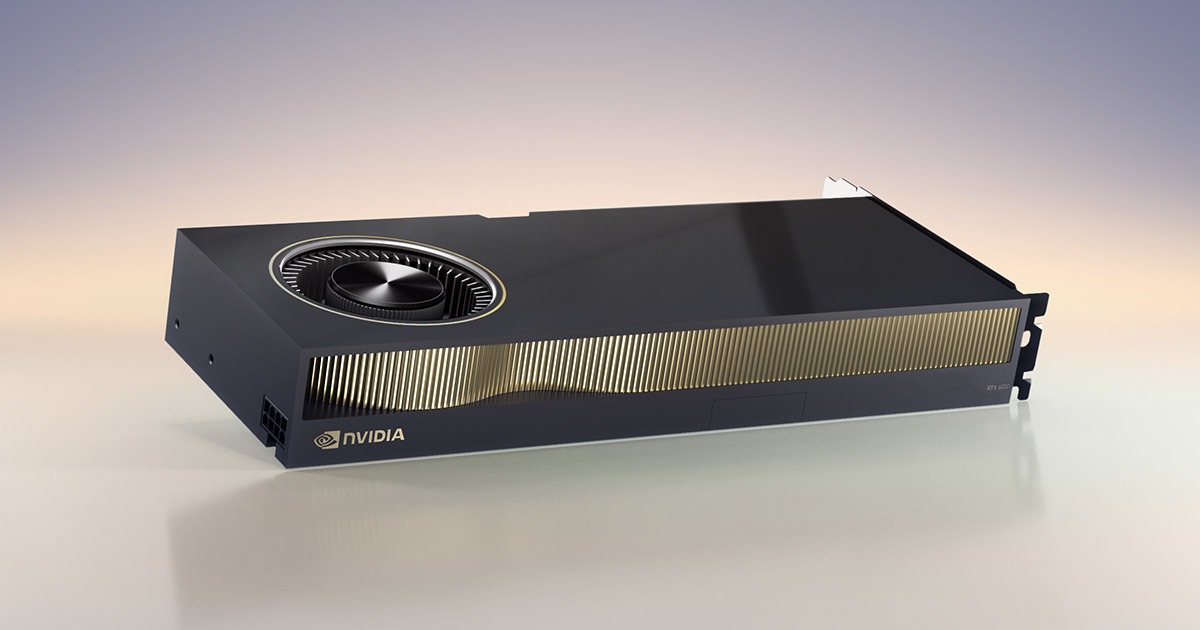
RTX 6000 Ada phù hợp để khảo sát khi dự án cần cả AI và ứng dụng thiết kế, dựng hình. Đừng nhầm với Quadro RTX 6000 đời Turing hoặc RTX PRO 6000 Blackwell: tên gần nhau nhưng dung lượng và thế hệ khác nhau.
Thông số cần biết trước khi chọn máy
Theo tài liệu chính hãng, cấu hình tham chiếu của NVIDIA RTX 6000 Ada có các thông số dưới đây. VRAM là bộ nhớ ngay trên GPU, khác RAM của máy chủ. Băng thông bộ nhớ cho biết khả năng trao đổi dữ liệu bên trong card; không phải tốc độ mạng Internet.
| Hạng mục | Thông số |
|---|---|
| Kiến trúc | Ada Lovelace |
| Bộ nhớ | 48 GB GDDR6 ECC |
| Băng thông bộ nhớ | 960 GB/s |
| Công suất | 300 W |
| Dạng kết nối | PCIe 4.0; không có NVLink |
Công suất trong bảng là giá trị tham chiếu của sản phẩm hoặc nền tảng, không phải mức điện máy luôn tiêu thụ. Khi chọn gói thuê, cần xem cả CPU, RAM hệ thống, ổ NVMe, đường mạng và số GPU. Hai máy cùng card có thể cho kết quả khác nhau nếu dữ liệu bị chờ ở CPU hoặc ổ đĩa.
Điểm mới của công nghệ có ích gì?
Tensor Cores thế hệ 4, RT Cores thế hệ 3 và 48 GB ECC là những điểm nổi bật của RTX 6000 Ada. Khác biệt với GeForce không chỉ nằm ở tốc độ: driver và hệ sinh thái ứng dụng chuyên nghiệp cũng cần được xem xét.
Tính toán Tensor là các phép toán ma trận phục vụ học sâu. Con số TFLOPS/TOPS cực đại mô tả khả năng tính toán trong điều kiện nhất định, không cho biết trực tiếp bao nhiêu câu trả lời mỗi giây. Muốn so card, hãy chạy cùng mô hình, cùng độ chính xác và cùng độ dài đầu vào; số học FP4, FP8 và FP16 không được xếp chung như một thang tốc độ.
Các phiên bản và dung lượng: đọc đúng tên sản phẩm
Ví dụ có phiên bản bộ nhớ thật: RTX 4060 Ti và RTX 5060 Ti có bản 8 GB/16 GB. Ngược lại, RTX 3090 24 GB, RTX 5090 32 GB và RTX A6000 48 GB là các model khác nhau, không phải ba bản bộ nhớ của một card. Phần mềm phải được thử lại khi đổi model hoặc dung lượng.
| Tên phiên bản hoặc dòng liên quan | Bộ nhớ | Điểm cần phân biệt |
|---|---|---|
| RTX 6000 Ada | 48 GB | Ada Lovelace |
| Quadro RTX 6000 | 24 GB | Model đời Turing; không phải RTX 6000 Ada 24 GB |
| RTX PRO 6000 Blackwell | 96 GB | Model thế hệ khác; không phải bản Ada 96 GB |
Không phải GPU nào cũng có đủ bản 16, 24, 32 và 48 GB. Thay quạt, ép xung hoặc đổi thương hiệu bo mạch không tự tạo một dung lượng VRAM mới. Card đã độ bộ nhớ và tài nguyên vGPU/MIG cần được ghi riêng, không trình bày như phiên bản chính hãng. Yêu cầu nhà cung cấp xác nhận mã SKU, dung lượng thực nhận và quyền dùng nguyên GPU hay một phần.
Những mô hình nào nên thử trên GPU này?
Qwen2.5-32B-Instruct 4-bit và Llama 3.1 70B 4-bit là các ứng viên cần thử. Mô hình 7B–8B BF16 có thể dành thêm VRAM cho batch hoặc đầu vào; SDXL cần kiểm thử riêng nếu chạy cùng ứng dụng đồ họa.
Các gợi ý ở đây là đánh giá dung lượng để chọn ứng viên thử nghiệm, chưa phải benchmark trên máy của thuemaychu.vn. Model card của Qwen2.5-32B-Instruct và Llama 3.1 70B Instruct giúp xác định đúng mô hình, điều kiện sử dụng và phần mềm. B là tỷ tham số; cùng tên họ mô hình vẫn có nhiều kích thước.
| Kích thước danh nghĩa | Trọng số BF16/FP16 lý tưởng | Trọng số 4-bit lý tưởng |
|---|---|---|
| 8B | Khoảng 16 GB | Khoảng 4 GB |
| 32B | Khoảng 64 GB | Khoảng 16 GB |
| 70B | Khoảng 140 GB | Khoảng 35 GB |
Lượng tử hóa là giảm số bit biểu diễn trọng số. Mốc 4-bit phía trên không phải dung lượng file hay bộ nhớ đo được: định dạng còn có hệ số tỉ lệ và dữ liệu phụ. KV cache là bộ nhớ giữ thông tin các token đã xử lý; nó tăng theo độ dài đầu vào và số phiên. Dung lượng thực tế cũng cần cộng phần engine, bộ nhớ tạm và các mô hình khác trong ứng dụng.
Một card 48 GB không chứa 70B BF16. Với 70B 4-bit khoảng 35 GB, phần cache và overhead quyết định còn bao nhiêu tải có thể phục vụ.
Chạy câu trả lời khác với tinh chỉnh mô hình
Inference là dùng mô hình để sinh kết quả. Fine-tuning là tinh chỉnh bằng dữ liệu mới, cần thêm bộ nhớ cho quá trình học. LoRA/QLoRA giảm phần phải huấn luyện nhưng vẫn phụ thuộc batch, độ dài chuỗi và công cụ. Một mô hình nạp vừa để inference không có nghĩa sẽ tinh chỉnh được với cùng cấu hình. Với SDXL, phải tính cả pipeline tạo ảnh và bộ tinh chỉnh nếu bật; độ phân giải và batch ảnh làm thay đổi mức dùng VRAM.
Điều kiện triển khai và giới hạn cần kiểm tra
Nếu đồng thời mở phần mềm 3D và server AI, phải trừ bộ nhớ của ứng dụng đồ họa khỏi ngân sách VRAM. Có ECC không có nghĩa mọi lỗi ứng dụng hay phần cứng đều được khắc phục.
- Chốt đúng checkpoint, phiên bản engine và phương pháp lượng tử hóa. Xem giấy phép mô hình trước khi dùng thương mại.
- Thử với một phiên và đầu vào ngắn, ghi mức VRAM cao nhất; sau đó tăng lần lượt độ dài và số phiên.
- Đo thời gian tới token đầu tiên, tốc độ sinh và tỷ lệ lỗi ở tải mục tiêu. Không chỉ đo một câu hỏi ngắn.
- Kiểm tra nhiệt độ, điện, ổ lưu dữ liệu và phục hồi dịch vụ sau khởi động lại. Với nhiều GPU, xác minh engine thật sự chia tải.
- Đặt giới hạn đầu vào và hàng đợi, dành dư địa bộ nhớ thay vì chạy sát dung lượng danh nghĩa.
Gửi yêu cầu cấu hình để nhận tư vấn phù hợp
Nếu đội bạn đang chọn GPU Server, gửi tên model, phiên bản, số người dùng đồng thời, độ dài tài liệu và ngân sách tới hotro@thuemaychu.vn hoặc gọi 028.888.70979. Yêu cầu xác nhận đúng GPU, dung lượng thực cấp, toàn bộ cấu hình máy và phép thử trước khi chốt. Xem bảng giá GPU Server; bài này không xác nhận card luôn sẵn hoặc gói thuê có cùng hiệu năng trên mọi ứng dụng.
NVIDIA RTX 6000 Ada có chạy được mọi model vừa VRAM không?
Không. Còn cần kernel và engine tương thích, bộ nhớ chạy, giấy phép mô hình và phép thử ở tải thực tế.
Có thể cộng VRAM của hai GPU như RAM máy chủ không?
Không tự động. Engine phải hỗ trợ chia mô hình và dữ liệu; kết nối, số phiên và độ dài đầu vào ảnh hưởng kết quả.
Card nhiều bộ nhớ hơn luôn nhanh hơn sao?
Không. Bộ nhớ giúp chứa thêm dữ liệu; tốc độ còn phụ thuộc tính toán, băng thông, phần mềm và tải.
Cần máy chủ cho workload này?
NOC thuemaychu.vn hỗ trợ chọn CPU, GPU và băng thông. PoC trong 24 giờ.
Bài viết liên quan
 GPU / AI
Cần bao nhiêu VRAM để chạy Llama 3.1 70B?
Tính riêng trọng số, KV cache và overhead; ví dụ context 8K, 32K và 128K với cache FP16.
 GPU / AI
GPU Server là gì? Cách chọn GPU cho mô hình ngôn ngữ lớn
Hướng dẫn chọn GPU Server theo workload: bộ nhớ, độ trễ, tải đồng thời và khả năng vận hành ứng dụng AI.
 GPU / AI
Thuê GPU hay dùng API AI? Cách tính điểm hòa vốn
Thuê GPU để tự phục vụ model và dùng API AI là hai phương án có cấu trúc chi phí khác nhau. API thường tính theo mức dùng hoặc hợp đồng; GPU có chi phí tài nguyên và đội vận hành, kể cả khi chưa sử dụng hết. Quyết định cần so cả chất lượng đầu ra, độ trễ và dữ liệu.