Cloudflare giảm 68% chi phí AI code review: 6 bài học triển khai
Cloudflare cho biết chi phí trung bình của hệ thống AI code reviewer giảm từ 2,43 USD xuống 0,77 USD sau tối ưu. Giá trị lớn nhất với đội AI là phương pháp đo, phân tầng và cắt token, không phải con số áp dụng cho mọi hệ thống.
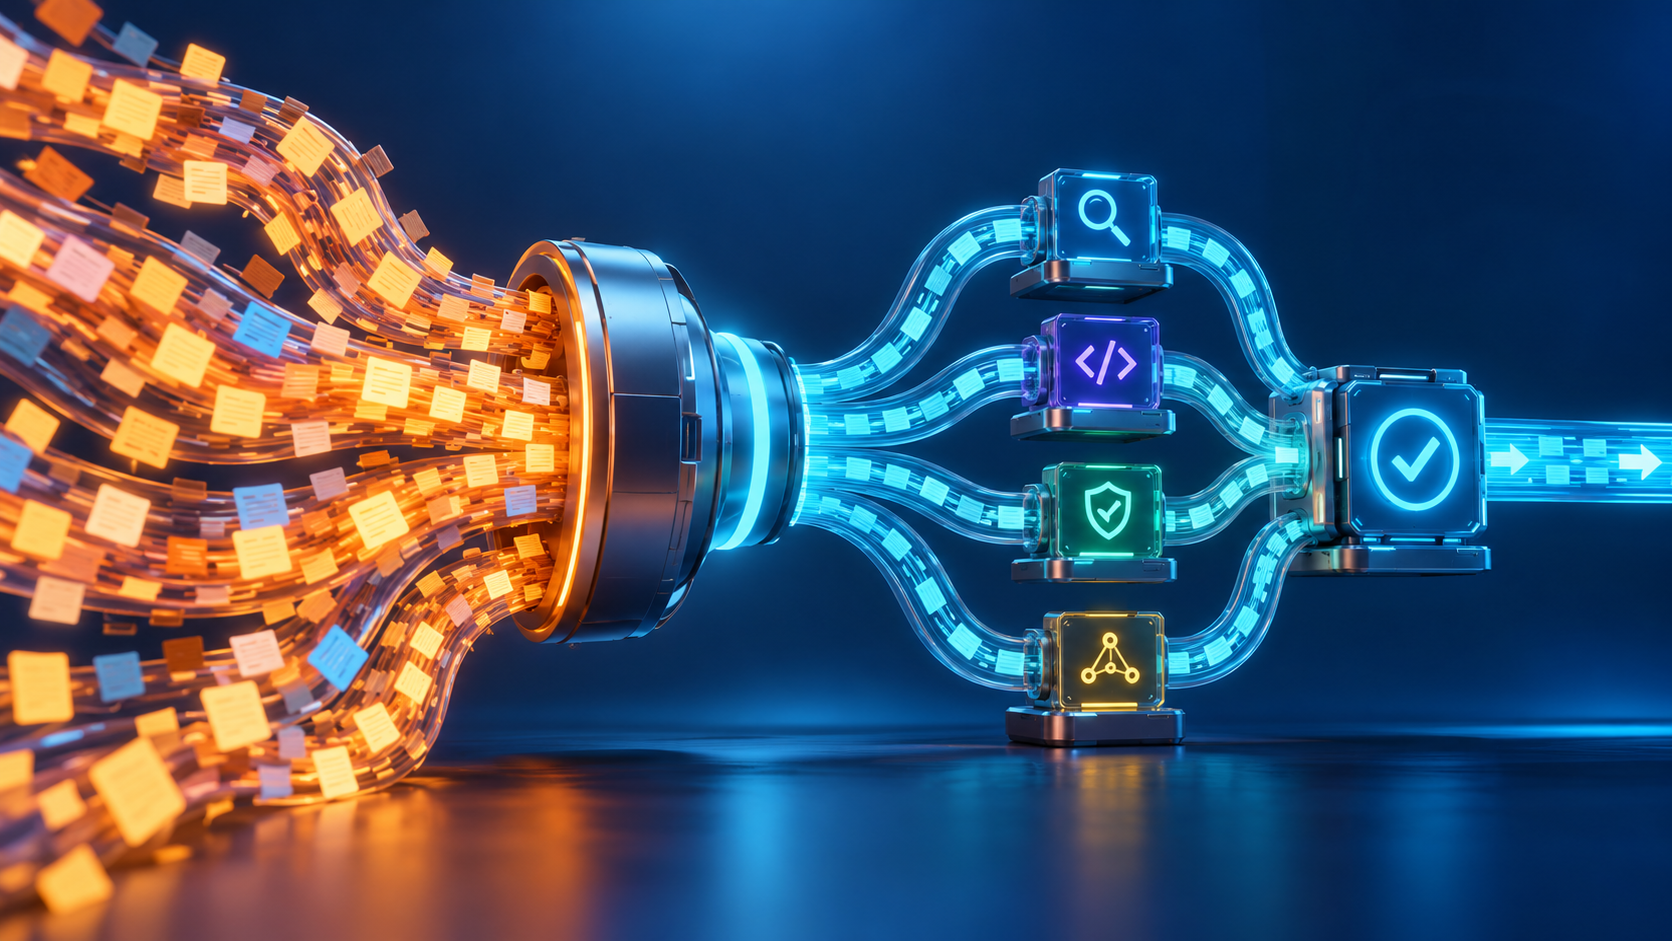
Một hệ thống AI code review có thể chạy ổn trong vài tháng rồi âm thầm tăng gấp đôi chi phí vì thay đổi lớn hơn, ngữ cảnh dài hơn và nhiều tác tử cùng đọc một dữ liệu. Cloudflare vừa công bố cách họ kéo chi phí trung bình xuống mạnh mà thời gian xử lý cũng ngắn hơn. Điều nên học là phương pháp tối ưu, không phải sao chép một con số.
Bài dành cho trưởng nhóm phát triển AI và kỹ sư vận hành agent. “Agent” ở đây là chương trình dùng mô hình để lập kế hoạch và gọi công cụ, ví dụ nhiều chuyên gia ảo cùng rà một pull request.
Số liệu Cloudflare công bố ngày 19/10/2026
Theo bài kỹ thuật của Cloudflare, chi phí trung bình mỗi lượt review từng tăng từ khoảng 1,19 USD lên 2,46 USD vào cuối tháng 8. Sau đợt tối ưu, mức trung bình còn 0,77 USD, giảm 68% so với 2,43 USD trong hai tuần đắt nhất.
Thời gian trung vị giảm từ 4 phút 09 giây xuống 1 phút 32 giây. Cloudflare ước tính khoảng 40% phần tiết kiệm đến từ thay đổi mã của reviewer; phần còn lại đến từ thử nghiệm lựa chọn mô hình và mức effort. Đây là số liệu nội bộ trên phân bố thay đổi mã của Cloudflare, không phải bảng giá hay cam kết hiệu năng cho doanh nghiệp khác.
Bài học 1: cố định phân bố tải trước khi so sánh
Cloudflare giữ cố định tỷ lệ các tầng review khi vẽ xu hướng chi phí, để ngày có nhiều thay đổi lớn không làm sai kết luận. Đội của bạn cũng nên phân nhóm theo số tệp, dòng thay đổi, ngôn ngữ và mức rủi ro. So sánh một tuần toàn việc nhỏ với tuần có nhiều migration sẽ không nói được tối ưu có hiệu quả hay không.
Bài học 2: đo token theo từng bước, không chỉ tổng hóa đơn
Gắn định danh cho coordinator và từng reviewer chuyên biệt. Ghi input token, output token, dữ liệu lặp lại, thời gian phản hồi và số lần gọi công cụ. Một tác tử có thể đọc lại cùng diff nhiều lần hoặc nhận toàn bộ kho mã dù chỉ cần vài tệp. Bản đồ chi phí theo bước giúp biết nên cắt ngữ cảnh ở đâu.
Bài học 3: giảm dữ liệu trước khi đổi sang mô hình rẻ hơn
Đổi mô hình thường dễ nhưng có thể làm mất lỗi quan trọng. Trước tiên hãy loại tệp sinh tự động, nội dung nhị phân, đoạn không liên quan và dữ liệu đã được reviewer trước tóm tắt. Dùng truy hồi có giới hạn để chỉ đưa vào các định nghĩa hoặc quy tắc cần thiết.
Bài học 4: phân tầng rủi ro và mức suy luận
Thay đổi tài liệu không cần quy trình giống sửa xác thực hoặc thanh toán. Xây ba tầng đơn giản: kiểm tra nhanh, review tiêu chuẩn và review chuyên sâu. Chỉ tăng effort hoặc gọi nhiều reviewer khi quy tắc rủi ro kích hoạt. Quy tắc phải có khả năng kiểm tra lại, không chỉ dựa vào cảm giác của mô hình.
Bài học 5: tối ưu đồng thời chi phí, thời gian và chất lượng
Nếu cắt token làm agent bỏ sót lỗi, chi phí thấp hơn không có giá trị. Hãy tạo bộ pull request lịch sử đã biết kết quả: lỗi bảo mật, hồi quy, cảnh báo giả và thay đổi hợp lệ. Mỗi phiên bản agent phải được chấm tỷ lệ phát hiện, cảnh báo sai, chi phí và p50/p95 thời gian xử lý.
Bài học 6: đặt ngân sách và đường lui
- Giới hạn token, số vòng và số lần gọi công cụ cho từng tầng review.
- Dừng hoặc hạ cấp khi vượt ngân sách, đồng thời ghi rõ review chưa hoàn tất.
- Cache dữ liệu ổn định như hướng dẫn coding và sơ đồ module, nhưng có thời hạn để tránh dùng thông tin cũ.
- Cho phép reviewer con trả về bằng chứng ngắn thay vì toàn bộ chuỗi suy luận.
- Giữ review của con người cho thay đổi quan trọng; agent là lớp hỗ trợ, không phải quyền phê duyệt cuối.
Tác động tới lựa chọn VPS hay GPU
Tối ưu phần mềm nên làm trước khi tăng máy. Nếu hệ thống gọi API mô hình bên ngoài, nâng GPU nội bộ không tự giảm hóa đơn token. Nếu tự vận hành mô hình, cắt ngữ cảnh có thể giảm bộ nhớ, tăng batch và rút ngắn hàng đợi; lúc đó mới đo xem CPU, RAM, GPU hay mạng là nút thắt.
Tách chi phí hạ tầng khỏi chi phí API, lưu trữ và công sức kỹ sư. Không suy ra mức giảm 68% sẽ lặp lại ở hệ thống khác; mục tiêu phải dựa trên số liệu của chính đội.
Có nên đổi ngay sang mô hình nhỏ để giảm chi phí?
Chưa chắc. Trước hết hãy đo dữ liệu lặp, cắt ngữ cảnh thừa và phân tầng rủi ro; sau đó thử mô hình nhỏ trên bộ đánh giá cố định.
Chỉ số nào quan trọng ngoài chi phí?
Tỷ lệ phát hiện lỗi, cảnh báo sai, p50/p95 thời gian xử lý, số lần gọi công cụ và tỷ lệ review phải chuyển cho người.
Nâng GPU có giải quyết chi phí token không?
Không nếu agent chủ yếu gọi API bên ngoài. Với mô hình tự vận hành, cần đo lại xem GPU thực sự là nút thắt sau khi giảm ngữ cảnh.
Nếu đội bạn đang tự vận hành mô hình cho code review, hãy gửi mô hình, độ dài ngữ cảnh, số lượt review mỗi ngày, p95 mong muốn và cách chấm chất lượng qua trang Thuê GPU Server. Mục đích là xây bài đo trước khi cân nhắc cấu hình, không mặc định rằng nâng GPU là câu trả lời.
Cần máy chủ cho workload này?
NOC thuemaychu.vn hỗ trợ chọn CPU, GPU và băng thông. PoC trong 24 giờ.
Bài viết liên quan
 GPU / AI
Cloudflare AI Gateway lỗi 401: đội làm chatbot cần xử lý gì?
Chatbot lỗi dù khách vẫn đăng nhập được? Tìm hiểu thay đổi 401/2009 của Cloudflare AI Gateway và các bước kiểm tra khóa truy cập, giới hạn thử lại, thông báo cho khách.
 GPU / AI
NVIDIA Nemotron 3.5 Bolt 24GB: chọn GPU chạy AI Agent
NVIDIA Nemotron 3.5 Bolt 74B-A9B được thiết kế để bản lượng tử hóa chạy trong 24GB bộ nhớ. Bài viết giúp đội AI phân biệt khả năng nạp mô hình với hiệu năng thực tế, đọc đúng benchmark của hãng và xây dựng bài thử trước khi chọn GPU.
 Bảo mật
CVE-2026-105192 trong LMCache: kiểm tra cụm LLM và vá
LMCache 0.3.9 đến 0.5.5 có thể bị thực thi lệnh từ xa nếu transport của chế độ multiprocess mở ra mạng. Bài viết giúp đội AI xác định đúng điều kiện rủi ro, nâng cấp đồng bộ lên 0.5.6 và rà cụm GPU an toàn.