CVE-2026-105192 trong LMCache: kiểm tra cụm LLM và vá
LMCache 0.3.9 đến 0.5.5 có thể bị thực thi lệnh từ xa nếu transport của chế độ multiprocess mở ra mạng. Bài viết giúp đội AI xác định đúng điều kiện rủi ro, nâng cấp đồng bộ lên 0.5.6 và rà cụm GPU an toàn.
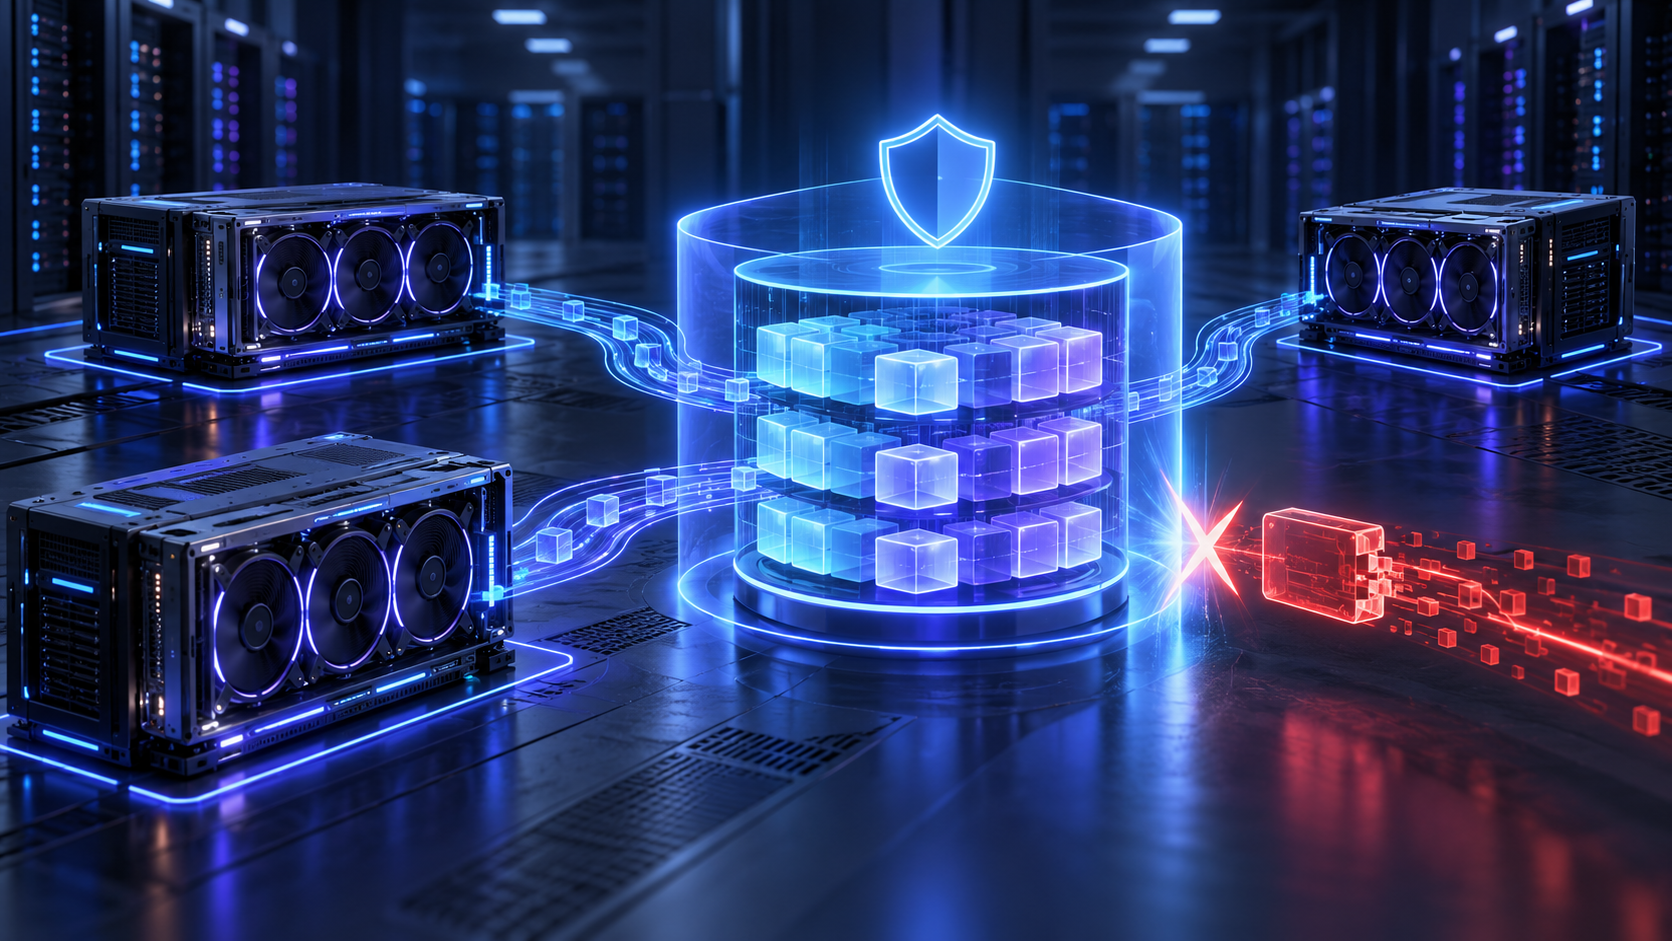
Một cụm phục vụ mô hình ngôn ngữ lớn có thể dùng LMCache để chia sẻ KV cache giữa các tiến trình hoặc máy chủ. KV cache là vùng nhớ lưu trạng thái của phần văn bản đã xử lý, giúp mô hình không phải tính lại toàn bộ prompt. Với CVE-2026-105192, chính đường truyền chia sẻ này có thể trở thành điểm thực thi lệnh từ xa nếu đội vận hành mở transport ra địa chỉ mạng có thể truy cập.
GitHub Advisory Database công bố bản ghi ngày 16/10/2026 và xếp mức Nghiêm trọng, CVSS 9,8/10. Phạm vi không phải mọi cài đặt LMCache: rủi ro chính nằm ở chế độ multiprocess, còn gọi là distributed mode, dùng ZeroMQ và bind vào địa chỉ có thể định tuyến. Cài đặt một máy giữ bind mặc định ở localhost không thể bị máy khác kết nối qua mạng theo mô tả của advisory.
Lỗ hổng nằm ở đâu?
LMCache multiprocess mở một ZeroMQ ROUTER để các worker đăng ký và chia sẻ các khối KV cache. Theo GHSA-w5f2-9q9c-ff4h, đường truyền này trước bản vá không có cơ chế xác thực thông điệp. Dữ liệu nhận vào có thể đi tới pickle.loads, hàm giải tuần tự hóa của Python vốn không an toàn với dữ liệu không tin cậy.
Giải tuần tự hóa là quá trình biến dữ liệu truyền qua mạng trở lại thành đối tượng trong chương trình. Với pickle, dữ liệu được chế tạo có thể khiến Python thực thi mã. Do đó, người có khả năng kết nối tới transport có thể chạy lệnh với quyền của tiến trình LMCache mà không cần đăng nhập. Advisory lưu ý image container chính thức trước đó chạy tiến trình bằng quyền root, làm hậu quả tiềm tàng lớn hơn.
Phiên bản và điều kiện bị ảnh hưởng
| Yếu tố | Trạng thái |
|---|---|
| Phiên bản LMCache | Từ 0.3.9 đến 0.5.5; các bản 0.5.6 release candidate đến rc3 và nhánh dev trước bản sửa cũng bị ảnh hưởng. |
| Bản đã sửa | 0.5.6 |
| Chế độ rủi ro | Multiprocess/distributed mode dùng ZeroMQ transport. |
| Điều kiện từ xa | Transport bind vào địa chỉ có thể định tuyến và kẻ tấn công kết nối được. |
| Cài đặt một máy mặc định | Bind localhost nên không thể bị máy khác truy cập trực tiếp. |
| LMCache chỉ chạy trong tiến trình vLLM | Không mở transport multiprocess được mô tả trong lỗ hổng. |
Điểm CVSS 9,8 áp dụng cho cấu hình transport có thể truy cập qua mạng. Không nên gán cùng mức phơi nhiễm cho máy chỉ bind localhost. Ngược lại, không được coi “mạng nội bộ” là an toàn tuyệt đối: cụm Kubernetes dùng mạng phẳng, pod bị chiếm quyền hoặc máy nhảy quản trị có thể tạo đường tới cổng dịch vụ.
Advisory không nêu bằng chứng CVE này đang bị khai thác thực tế và tại thời điểm kiểm tra không phải cảnh báo CISA KEV được dẫn trong bản ghi. Mức nghiêm trọng đến từ điều kiện kỹ thuật: không cần xác thực, tấn công qua mạng và có thể chiếm quyền tiến trình. Đội vận hành nên ưu tiên xử lý dựa trên khả năng tiếp cận transport của chính cụm.
Bản vá 0.5.6 thay đổi gì?
LMCache 0.5.6 bỏ cơ chế pickle ở đường truyền này, dùng mô tả MessagePack có kiểu và phiên bản, kiểm tra dữ liệu trước khi sử dụng và chỉ chọn loại device wrapper từ danh sách cục bộ cho phép. Bản sửa áp dụng cho cả đường ZeroMQ và gRPC. Image chính thức cũng chuyển sang người dùng không phải root, còn ví dụ Kubernetes bind localhost.
Định dạng trao đổi giữa các worker đã thay đổi, vì vậy advisory yêu cầu nâng cấp toàn bộ worker và server cùng nhau. Nâng từng nút trong khi giữ phiên bản cũ và mới giao tiếp có thể gây lỗi tương thích. Hãy chuẩn bị cửa sổ bảo trì, tạm rút lưu lượng hoặc dựng cụm song song để xác minh trước khi chuyển hệ thống đang phục vụ khách hàng.
Checklist kiểm tra và xử lý
- Lập danh sách image, package và commit LMCache trên mọi worker; không suy phiên bản chỉ từ manifest triển khai.
- Xác định có dùng multiprocess/distributed mode hay không và ghi lại tham số host, cổng cùng namespace mạng.
- Kiểm tra firewall, security group và Kubernetes NetworkPolicy để biết những pod, node hoặc mạng nào kết nối được tới transport.
- Nếu chưa thể vá ngay, giữ transport ở localhost hoặc mạng cụm tin cậy, chặn truy cập không cần thiết và chạy tiến trình bằng người dùng không phải root.
- Nâng đồng bộ server và worker lên LMCache 0.5.6; kiểm tra tương thích với vLLM, image CUDA và cấu hình cache.
- Sau nâng cấp, thử nạp prompt, tái sử dụng prefix, thu hồi cache, lỗi node và khả năng khôi phục; theo dõi thời gian phản hồi lẫn tỷ lệ trúng cache.
- Nếu transport từng mở ra mạng không tin cậy, rà kết nối tới dịch vụ, tiến trình lạ, kết nối ra ngoài và thay khóa truy cập có thể bị tiến trình LMCache đọc.
- Triển khai lại từ image sạch khi có dấu hiệu xâm nhập; không coi việc cài package mới là đủ để loại bỏ thay đổi đã xảy ra.
Tác động đến cụm GPU và chi phí suy luận
Tắt LMCache vội vàng có thể làm tăng thời gian xử lý prompt và tải GPU, đặc biệt khi nhiều yêu cầu dùng chung phần đầu dài. Tuy nhiên, giữ một transport có thể truy cập mà chưa vá tạo rủi ro lớn hơn lợi ích hiệu năng. Phương án hợp lý là cô lập đường truyền, nâng cấp đồng bộ và đo lại tỷ lệ trúng cache sau thay đổi.
Đội AI nên tách chỉ số an toàn và hiệu năng. Về an toàn: không chạy root, chỉ cho worker cần thiết kết nối và ghi nhật ký luồng mạng. Về hiệu năng: đo thời gian nhận token đầu tiên, thông lượng, bộ nhớ GPU và tỷ lệ cache hit. Bài chọn GPU Server cho LLM giúp xác định chỉ số nền; bài Rubin CPX và inference context dài giải thích vì sao xử lý prompt là phần quan trọng của tải.
Nguồn tham khảo
- GitHub Advisory Database: GHSA-w5f2-9q9c-ff4h / CVE-2026-105192, cập nhật 16/10/2026
- NVD: CVE-2026-105192
- LMCache: thông báo về CVE-2026-105192, ngày 13/10/2026
LMCache chạy cùng vLLM trên một máy có bị ảnh hưởng không?
Nếu LMCache chỉ chạy trong tiến trình vLLM và không mở transport multiprocess thì không gặp đường tấn công được advisory mô tả. Vẫn cần kiểm tra cấu hình thực tế thay vì suy từ kiến trúc dự kiến.
Có thể chỉ chặn cổng mà chưa nâng cấp không?
Chặn truy cập là biện pháp giảm thiểu tạm thời. Bản vá 0.5.6 loại bỏ cơ chế giải tuần tự hóa không an toàn và nên được triển khai đồng bộ khi có thể.
Vì sao phải nâng toàn bộ worker cùng lúc?
Bản 0.5.6 thay đổi định dạng trao đổi trên đường truyền. Worker và server cũ, mới có thể không tương thích, nên advisory yêu cầu nâng cả cụm đồng bộ.
Nếu đội AI đang vận hành LMCache trên cụm GPU, hãy chuẩn bị phiên bản package/image, sơ đồ worker, địa chỉ bind, NetworkPolicy và thời gian bảo trì. Gửi các thông tin này qua kênh hỗ trợ trên trang GPU Server để đối chiếu lớp mạng và tài nguyên cho bài thử sau nâng cấp; việc xác nhận và vá LMCache vẫn phải theo advisory của dự án.
Cần máy chủ cho workload này?
NOC thuemaychu.vn hỗ trợ chọn CPU, GPU và băng thông. PoC trong 24 giờ.
Bài viết liên quan
 GPU / AI
GPU Server là gì? Cách chọn GPU cho mô hình ngôn ngữ lớn
Hướng dẫn chọn GPU Server theo workload: bộ nhớ, độ trễ, tải đồng thời và khả năng vận hành ứng dụng AI.
 GPU / AI
NVIDIA Rubin CPX: GPU cho inference context dài và coding agent
Ứng dụng coding agent có thể đọc repository, lịch sử trao đổi và nhiều tài liệu trước khi sinh câu trả lời. Khi đầu vào dài, thời gian xử lý prompt trở thành một phần quan trọng của trải nghiệm. Rubin CPX là sản phẩm NVIDIA giới thiệu nhằm phục vụ hướng xử lý context rất lớn này.
 GPU / AI
Backup checkpoint và dữ liệu trên GPU Server
Dữ liệu trên GPU Server có thể gồm checkpoint tải về, dataset riêng, trọng số tinh chỉnh, cấu hình và kết quả chạy. Khi kết thúc thuê hoặc máy lỗi, mất một artifact nhỏ nhưng không thể tái tạo có thể làm mất nhiều giờ tính toán.