Ba cách tối ưu MoE inference trên NVIDIA DGX Spark
NVIDIA kết hợp Humming, lượng tử hóa FP8 và speculative decoding để tăng tốc Ling-3.0-flash trên DGX Spark. Các con số là benchmark hãng và cần được đo lại.
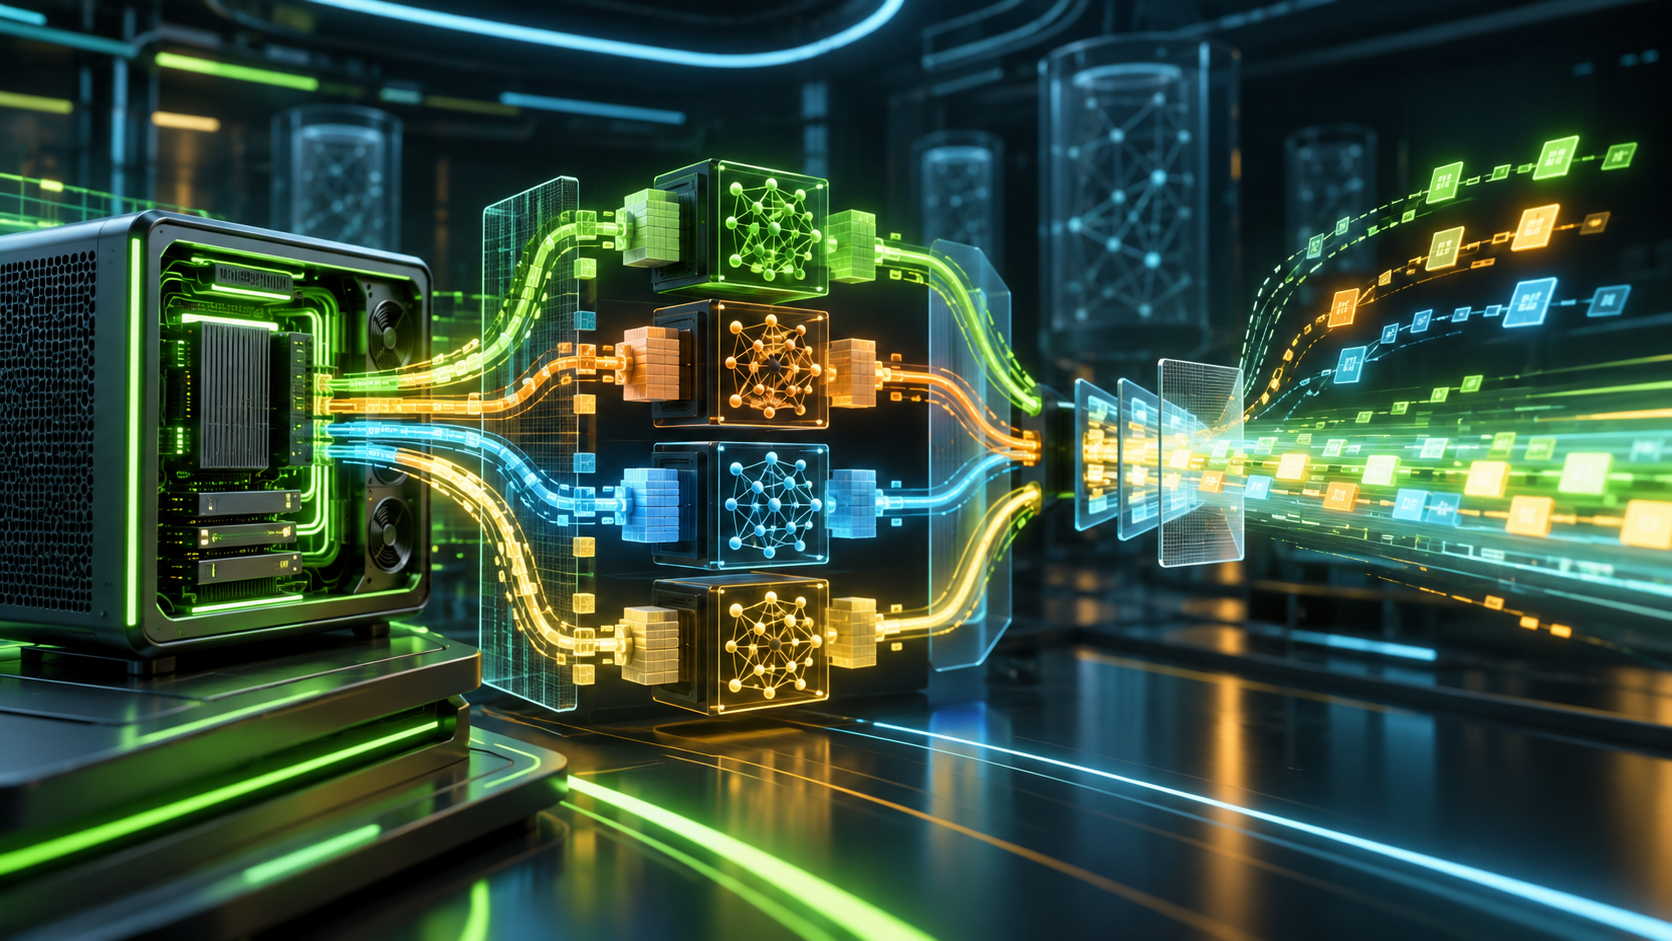
Một mô hình MoE có thể chỉ kích hoạt một phần tham số cho mỗi token, nhưng điều đó không có nghĩa suy luận sẽ tự nhanh. Khi batch nhỏ, hệ thống có thể bị giới hạn bởi việc đọc trọng số, lớp đầu ra lớn hoặc số bước giải mã. Đội phát triển chatbot cần biết nút thắt nằm ở đâu trước khi thêm GPU.
Ngày 27/10/2026, NVIDIA công bố ba kỹ thuật tối ưu Ling-3.0-flash trên DGX Spark. Bài viết này dành cho đội phát triển LLM và kỹ sư hiệu năng, tập trung vào cách đọc benchmark thay vì sao chép một cấu hình rồi kỳ vọng cùng kết quả.
Mô hình và điều kiện thử nghiệm
Theo NVIDIA Technical Blog, Ling-3.0-flash có 124 tỷ tham số tổng, nhưng chỉ 5,1 tỷ tham số hoạt động cho mỗi token. Mỗi lớp MoE định tuyến một token tới 8 trong 512 chuyên gia cùng một chuyên gia dùng chung. Bài thử dùng batch size 1 trên DGX Spark.
Baseline dùng FlashInfer MXFP4 cho MoE, CUDA dense GEMM và đầu ra FP32. Trong phép đo tổng hợp với đầu vào 32K token, đầu ra 2K token, NVIDIA xác định giải mã bị giới hạn bởi băng thông bộ nhớ. Đây là điều kiện cụ thể, không phải mô tả cho mọi mô hình MoE.
Ba kỹ thuật được thử
1. Humming cho kernel MoE
Humming biên dịch kernel theo đúng kích thước tensor, kiểu dữ liệu và kiến trúc GPU lúc chạy, sau đó lưu vào cache. Trên workload tổng hợp, thời gian cho mỗi token đầu ra giảm từ 27,71 ms xuống 25,35 ms, tương ứng thông lượng tăng 9,3%. Đây là số liệu do NVIDIA công bố.
2. Lượng tử hóa FP8 cho LM head
LM head là lớp chiếu từ trạng thái ẩn sang toàn bộ từ vựng. Bản checkpoint giữ lớp này ở BF16, nên mỗi token phải đọc một khối trọng số lớn. Chuyển riêng LM head sang FP8 làm giảm một nửa lượng dữ liệu trọng số cần đọc. Khi kết hợp với Humming, thông lượng tổng hợp tăng 21,7% so với baseline.
3. Speculative decoding bằng NEXTN
Speculative decoding cho mô hình nháp đề xuất nhiều token rồi mô hình chính kiểm tra cùng lúc. Ling-3.0-flash có sẵn lớp NEXTN, nên không cần tải mô hình nháp riêng. Trên workload tổng hợp, cả ba kỹ thuật đạt mức tăng 185,1%; nhưng NVIDIA cảnh báo dữ liệu lặp và greedy decoding khiến tỷ lệ chấp nhận token cao bất thường.
Benchmark thực tế hơn nói gì?
NVIDIA tiếp tục chạy toàn bộ 1.319 câu hỏi GSM8K. Ba tối ưu tăng thông lượng giải mã 42,5%, giảm thời gian phản hồi trung bình 24,5% và không ghi nhận thay đổi độ chính xác có ý nghĩa thống kê. Mức tăng thấp hơn đáng kể so với bài tổng hợp, vì đầu ra ngắn hơn và cách lấy mẫu khó dự đoán hơn.
Có một bẫy cấu hình đáng chú ý: khi FP8 LM head và NEXTN cùng bật, mô hình nháp phải dùng chung toàn bộ module LM head với mô hình chính. Nếu chỉ chia sẻ tensor trọng số, hệ thống có thể âm thầm đọc FP8 như BF16, tỷ lệ chấp nhận giảm và hiệu năng còn thấp hơn baseline.
Checklist cho đội triển khai LLM
- Đo riêng prefill, thời gian đến token đầu tiên, thời gian mỗi token đầu ra và thông lượng; không gộp thành một con số duy nhất.
- Chạy dữ liệu thật với phân bố độ dài đầu vào, đầu ra, sampling và tool call giống hệ thống đang phục vụ khách hàng.
- Xác nhận backend MoE, LM head FP8 và speculative decoding thực sự được bật trong log khởi động.
- So sánh chất lượng bằng bộ đánh giá của doanh nghiệp, không chỉ GSM8K.
- Đo VRAM, thời gian biên dịch kernel, cache khởi động và hiệu quả khi có nhiều request đồng thời.
- Giữ một cấu hình baseline để có thể quay lại nếu phiên bản SGLang, kernel hoặc model thay đổi.
Ý nghĩa với doanh nghiệp Việt Nam
Bài thử cho thấy tối ưu phần mềm có thể mang lại lợi ích trước khi mở rộng phần cứng. Tuy vậy, DGX Spark, batch size 1 và Ling-3.0-flash không đại diện cho GPU máy chủ nhiều người dùng. Với dịch vụ chatbot, số người đồng thời, độ dài ngữ cảnh và yêu cầu thời gian phản hồi mới quyết định cấu hình.
Nếu đội AI muốn so sánh tự phục vụ mô hình với API, có thể xem bài tính điểm hòa vốn GPU và API AI. Khi cần thử trên GPU server, hãy gửi tên checkpoint, kiểu lượng tử hóa, context, batch, số request đồng thời và mục tiêu p95 tới hotro@thuemaychu.vn để xây dựng bài đo phù hợp, không dùng benchmark hãng làm cam kết.
Nguồn tham khảo
Mức tăng 185,1% có áp dụng cho chatbot thật không?
Không thể suy luận như vậy. Đây là bài tổng hợp với đầu vào 32K, đầu ra 2K, batch 1 và greedy decoding. Trên GSM8K, mức tăng thông lượng NVIDIA đo được là 42,5%.
MoE là gì?
Mixture-of-experts là kiến trúc có nhiều nhóm chuyên gia nhưng chỉ kích hoạt một phần cho mỗi token. Cách định tuyến giúp giảm tính toán, nhưng vẫn có thể bị nghẽn bởi đọc trọng số và giao tiếp.
Có cần thêm GPU trước khi tối ưu không?
Chưa chắc. Nên đo nút thắt trước. Nếu hệ thống bị giới hạn bởi kernel, lớp đầu ra hoặc số bước giải mã, tối ưu phần mềm có thể cải thiện đáng kể.
Cần máy chủ cho workload này?
NOC thuemaychu.vn hỗ trợ chọn CPU, GPU và băng thông. PoC trong 24 giờ.
Bài viết liên quan
 GPU / AI
Cụm 8 DGX Spark chạy mô hình 753B: đọc đúng benchmark NVIDIA
NVIDIA công bố ngày 22/10/2026 rằng tám DGX Spark có thể ghép thành cụm 1TB bộ nhớ hợp nhất. Các con số hiệu năng là benchmark của hãng.
 GPU / AI
TensorRT 11.1 Global Performance Tuner: tối ưu inference thế nào?
NVIDIA công bố ngày 23/10/2026 cách Global Performance Tuner trong TensorRT 11.1 thử nhiều lộ trình biên dịch, loại phương án không đạt độ chính xác và chọn engine nhanh nhất trong phép đo.
 GPU / AI
Thuê GPU hay dùng API AI? Cách tính điểm hòa vốn
Thuê GPU để tự phục vụ model và dùng API AI là hai phương án có cấu trúc chi phí khác nhau. API thường tính theo mức dùng hoặc hợp đồng; GPU có chi phí tài nguyên và đội vận hành, kể cả khi chưa sử dụng hết. Quyết định cần so cả chất lượng đầu ra, độ trễ và dữ liệu.