Vera Rubin tối ưu HBM và KV cache cho suy luận AI ra sao?
NVIDIA cho rằng hiệu quả suy luận không chỉ phụ thuộc dung lượng HBM mà còn ở độ chính xác số, cách phân bổ mô hình, định tuyến KV cache và tầng lưu trữ.
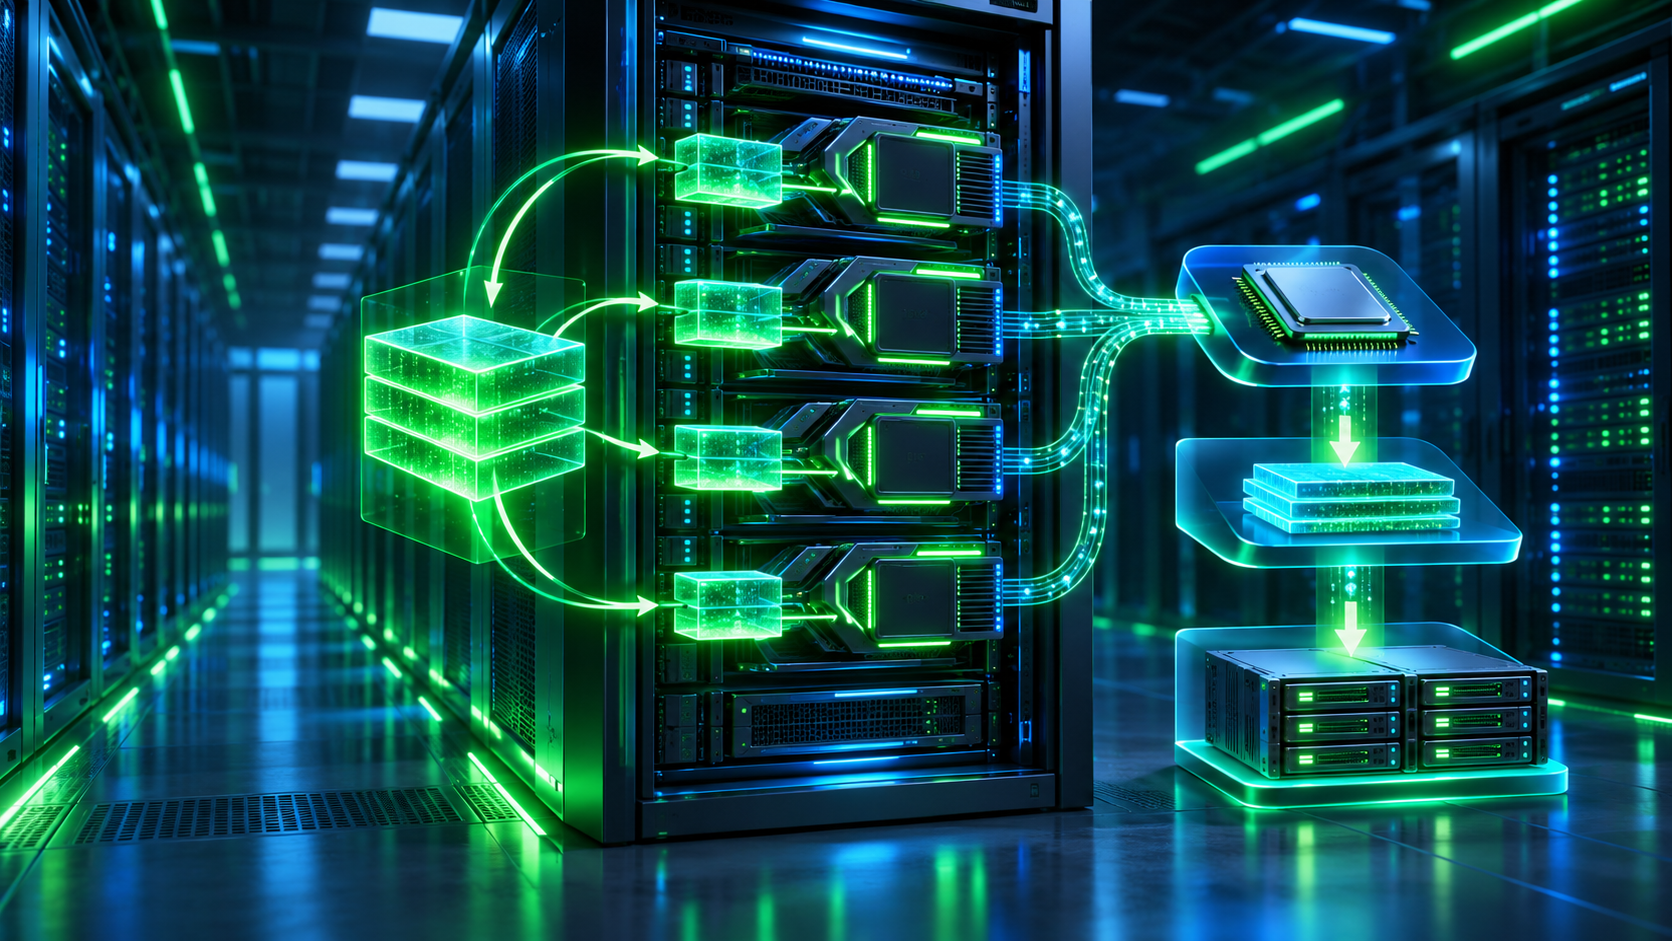
Một mô hình có thể nạp vừa GPU nhưng vẫn phục vụ chậm khi nhiều người dùng giữ ngữ cảnh dài. Lý do thường không nằm ở số GB HBM đơn thuần mà ở cách trọng số, KV cache và dữ liệu được di chuyển, giữ lại hoặc tính lại. Ngày 05/11/2026, NVIDIA công bố cách nhìn năm lớp cho bài toán này trên hạ tầng Vera Rubin.
Từ dung lượng HBM tới giá trị của từng byte
Theo NVIDIA Technical Blog, mỗi Rubin GPU có tối đa 288 GB HBM4 và băng thông bộ nhớ 19,2 TB/s. Hãng nhấn mạnh dung lượng trên mỗi GPU tương đương GB300, nhưng hiệu quả hệ thống đến từ đồng thiết kế độ chính xác số, liên kết GPU, phần mềm phục vụ, CPU và lưu trữ.
HBM là bộ nhớ băng thông cao đặt gần GPU. KV cache là trạng thái chú ý đã tính từ các token trước, giúp mô hình không phải xử lý lại toàn bộ ngữ cảnh ở mỗi bước. Với chatbot và AI agent, KV cache có thể chiếm phần lớn bộ nhớ khi số phiên đồng thời và độ dài hội thoại tăng.
Năm lớp tối ưu được NVIDIA mô tả
- NVFP4 giảm kích thước trọng số và KV cache. NVIDIA cho biết trọng số NVFP4 nhỏ hơn khoảng 3,5 lần so với FP16 và KV cache có thể giảm tới 50% so với FP8.
- Wide Expert Parallelism trải các expert của mô hình MoE qua nhiều GPU, để lại thêm HBM cho batch và KV cache; hiệu quả phụ thuộc mạnh vào liên kết all-to-all.
- NVLink biến vùng scale-up thành không gian bộ nhớ kết nối tốc độ cao. NVIDIA nêu NVL72 Rubin có khoảng 20,7 TB HBM4 trên toàn rack.
- NVIDIA Dynamo định tuyến yêu cầu tới nơi đã có prefix phù hợp, tách prefill khỏi decode và theo dõi KV cache qua GPU, RAM, SSD hoặc lưu trữ mạng.
- CMX bổ sung tầng lưu trữ chia sẻ ở cấp pod để giữ và tái sử dụng ngữ cảnh giữa node thay vì tính lại.
Đọc benchmark 30 lần đúng cách
NVIDIA công bố Vera Rubin NVL72 đạt tới 30 lần thông lượng agentic trên mỗi megawatt so với GB300 NVL72 ở mức 160 token/giây/người dùng trên bài đo SemiAnalysis AgentX. Đây là benchmark do hãng trích dẫn, với cấu hình rack, mô hình, độ chính xác và mục tiêu tương tác cụ thể; không phải cam kết rằng mọi workload sẽ tăng 30 lần.
Tương tự, số liệu NVFP4 đạt tới bốn lần thông lượng so với FP8 và giữ hơn 99% điểm BF16 trên nhóm bài thử cần được xem cùng độ lệch chất lượng từng tác vụ. Đội AI tiếng Việt phải đo lại độ chính xác, gọi công cụ, RAG và dữ liệu chuyên ngành của mình.
Ảnh hưởng tới khách thuê GPU tại Việt Nam
Với một hoặc vài GPU PCIe, doanh nghiệp chưa có toàn bộ lợi ích của NVL72, NVLink scale-up và CMX. Tuy nhiên, nguyên tắc vẫn hữu ích: chọn định dạng số phù hợp, đo KV cache mỗi phiên, dùng prefix caching, tách tải prefill/decode khi quy mô đủ lớn và tránh giữ phiên nhàn rỗi trong HBM.
- Đo thời gian phản hồi token đầu và tốc độ sinh token riêng, không gộp thành một chỉ số.
- Ghi lại model, lượng tử hóa, độ dài ngữ cảnh, số phiên đồng thời và batch khi benchmark.
- So sánh chất lượng đầu ra FP16/FP8/NVFP4 trên dữ liệu Việt Nam trước khi đổi định dạng.
- Theo dõi tỷ lệ cache hit, lưu lượng liên GPU và thời gian di chuyển cache giữa HBM, RAM và SSD.
- Tính điện năng, mạng và lưu trữ theo toàn hệ thống; không chỉ so giá GPU.
Khi nào cần rack-scale?
Rack-scale phù hợp với mô hình MoE lớn, ngữ cảnh dài và tải đồng thời đủ cao để bù độ phức tạp vận hành. Với chatbot nội bộ, OCR hoặc RAG quy mô vừa, một máy chủ nhiều GPU có cấu hình tốt có thể kinh tế hơn. Quyết định nên dựa trên đường cong tải thực tế, không dựa vào thông số đỉnh.
288 GB HBM có nghĩa chạy được mọi mô hình 288 GB không?
Không. Cần chừa bộ nhớ cho KV cache, runtime, buffer và batch; mô hình nhiều GPU còn phụ thuộc cách chia trọng số và liên kết.
NVFP4 luôn tốt hơn FP8 không?
Không. NVFP4 giảm bộ nhớ và có thể tăng thông lượng, nhưng phải đo lại chất lượng và khả năng hỗ trợ của phần cứng, framework.
KV cache có thể lưu xuống SSD không?
Có trong một số kiến trúc phân tầng, nhưng thời gian truy xuất chậm hơn HBM. Cần đo tỷ lệ tái sử dụng và chi phí di chuyển dữ liệu.
Bước tiếp theo
Đội AI có thể gửi tên mô hình, định dạng số, độ dài ngữ cảnh, số phiên đồng thời và GPU đang dùng qua trang liên hệ. Những thông tin này giúp xây bài benchmark sát nhu cầu trước khi chọn máy chủ hoặc cụm GPU.
Cần máy chủ cho workload này?
NOC thuemaychu.vn hỗ trợ chọn CPU, GPU và băng thông. PoC trong 24 giờ.
Bài viết liên quan
 GPU / AI
CUDA 13.5 thay đổi cách chia sẻ GPU với MPS v3
CUDA 13.5 hỗ trợ chính thức kiến trúc Vera Rubin, đồng thời bổ sung nhiều cơ chế điều phối MPS v3. Bài viết phân tích giá trị thực tế, điều kiện áp dụng và cách thử nghiệm an toàn.
 GPU / AI
NVIDIA Dynamo AICR: dựng runtime Kubernetes có kiểm chứng
NVIDIA công bố công thức AICR cho Dynamo ngày 30/10/2026, đóng gói GPU Operator, DRA, KAI Scheduler, Grove và giám sát. Đây là hướng chuẩn hóa cụm inference, không phải nút cài đặt thay thế vận hành.
 GPU / AI
Vera Rubin và Vera CPU lên OCI: doanh nghiệp cần đọc gì?
Oracle và NVIDIA đưa Vera Rubin NVL72 cùng Vera CPU lên OCI. Bài viết tách rõ phần đã sẵn sàng, lộ trình và các bước đánh giá trước khi chọn hạ tầng AI.