NVIDIA Mission Control 2.5: tự phục hồi job GPU trên Kubernetes
Mission Control 2.5 phối hợp bộ lập lịch, phục hồi job và chẩn đoán phần cứng để giảm thời gian gián đoạn cho cụm GPU Kubernetes.
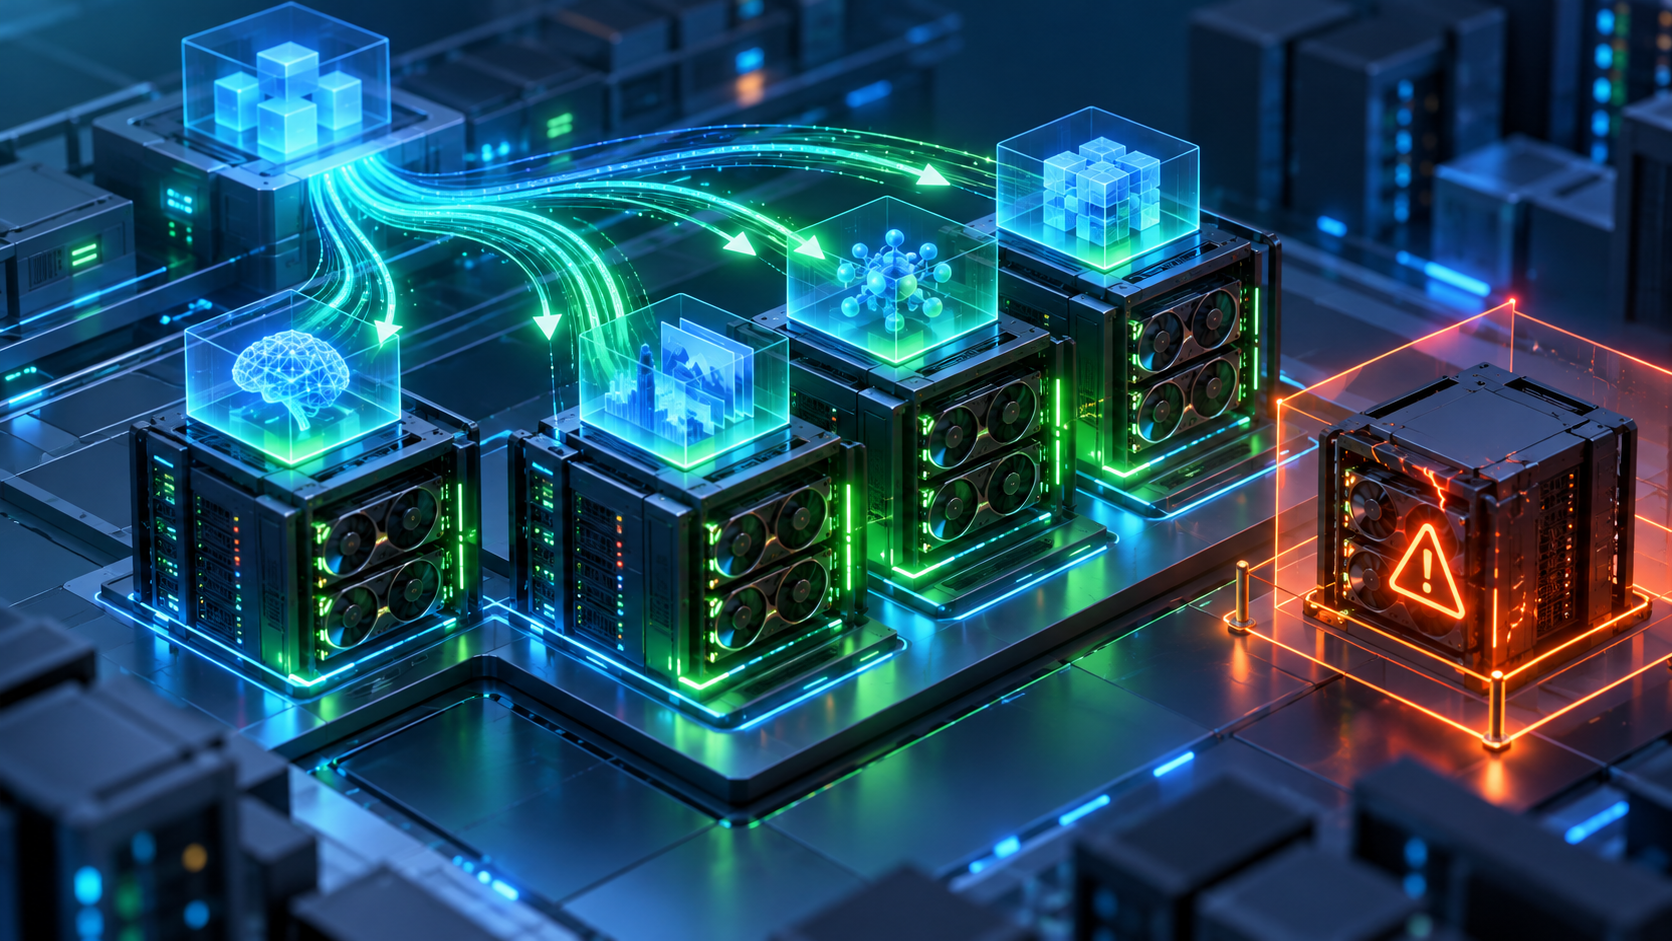
Khi một GPU lỗi giữa job huấn luyện nhiều ngày, đội vận hành thường phải làm hai việc song song: đưa workload trở lại chạy và tìm nguyên nhân phần cứng. Nếu chờ chẩn đoán xong mới khôi phục job, cụm mất thời gian; nếu chỉ chạy lại mà không cô lập node lỗi, job tiếp theo có thể gặp đúng sự cố.
NVIDIA công bố Mission Control 2.5 ngày 26/10/2026. Điểm mới quan trọng là động cơ phục hồi tự động, trước đây tập trung vào workload HPC dùng Slurm, nay mở rộng sang workload Kubernetes được quản lý bằng NVIDIA Run:ai. Phiên bản 2.5 được hãng cho biết đã sẵn sàng sử dụng.
Vòng điều khiển ba lớp hoạt động ra sao?
Theo NVIDIA Technical Blog, Mission Control tách ba trách nhiệm để tránh một thành phần phải hiểu toàn bộ hệ thống.
- Bộ lập lịch Kubernetes/Run:ai đặt workload lên phần năng lực còn khả dụng.
- Dịch vụ phục hồi job giữ ngữ cảnh workload, lịch sử lỗi và quyết định thử lại, xếp hàng lại hoặc chuyển vị trí.
- Dịch vụ phục hồi phần cứng theo dõi node và GPU, cô lập phần cứng đáng ngờ rồi chạy chẩn đoán hoặc biện pháp khắc phục.
Khi gặp lỗi phần cứng, đường phục hồi workload và đường chẩn đoán chạy song song. Job có thể khởi động lại trên GPU khỏe trong khi node lỗi bị đánh dấu không thể nhận lịch. Với lỗi phần mềm tạm thời, hệ thống có thể chỉ thử lại job, tránh rút nhầm phần cứng tốt khỏi cụm.
Ba tình huống đội vận hành cần kiểm thử
| Tình huống | Phản ứng mong đợi | Rủi ro cần kiểm soát |
|---|---|---|
| GPU báo ECC hoặc worker treo | Khôi phục job và cô lập node song song | Checkpoint hỏng hoặc lặp khởi động |
| Lỗi phần mềm tạm thời | Thử lại theo chính sách, không cách ly phần cứng | Vòng lặp thử lại che lỗi thật |
| Node suy giảm trước khi job lỗi | Rút node khỏi lịch và chạy chẩn đoán | Giảm dung lượng quá mức vì cảnh báo sai |
Tự phục hồi không đồng nghĩa không mất dữ liệu công việc. Job vẫn cần checkpoint, tức bản lưu trạng thái cho phép tiếp tục thay vì chạy lại từ đầu. Chu kỳ checkpoint phải cân bằng thời gian ghi dữ liệu, dung lượng lưu trữ và lượng tính toán chấp nhận mất khi sự cố xảy ra.
Điểm cần phân biệt với thông điệp “tự chữa lành”
Mission Control có thể tự động hóa quyết định vận hành, nhưng chất lượng phụ thuộc tín hiệu sức khỏe, khả năng phân loại lỗi và tích hợp bộ lập lịch. Nếu cảnh báo ECC, mạng hoặc lưu trữ không đầy đủ, hệ thống không thể suy luận chính xác. Doanh nghiệp cũng phải định nghĩa khi nào được thử lại, khi nào dừng job và khi nào cần người phê duyệt.
Trong bản 2.5, phát hiện bất thường mạng bằng AI mới ở trạng thái beta, còn hỗ trợ NVIDIA Vera Rubin NVL72 là early access. Hai phần này không nên được coi là tính năng ổn định chung hoặc dùng để cam kết lộ trình phần cứng.
Checklist triển khai an toàn
- Kiểm kê phiên bản Kubernetes, Run:ai, driver GPU, GPU Operator, container runtime và cơ chế checkpoint của framework.
- Chuẩn hóa nhãn node, vùng lỗi, nhóm GPU và hàng đợi để bộ lập lịch không chuyển job sang tài nguyên không tương thích.
- Đặt giới hạn số lần thử lại, khoảng nghỉ và điều kiện dừng để tránh vòng lặp tiêu tốn GPU.
- Kiểm thử bằng lỗi có kiểm soát: worker thoát, timeout NCCL, GPU bị đánh dấu không khỏe và node mất kết nối.
- Xác minh node bị cô lập không nhận job mới, lý do được ghi lại và chỉ quay lại sau bài kiểm tra sức khỏe.
- Đo thời gian phát hiện, thời gian job chạy lại, lượng công việc mất từ checkpoint và số cảnh báo sai.
- Giữ quyền phê duyệt cho thay đổi có tác động lớn như khởi động lại node, cập nhật firmware hoặc đưa phần cứng trở lại cụm.
Doanh nghiệp Việt Nam nên bắt đầu từ đâu?
Đội có cụm Kubernetes GPU nhiều node và job chạy hàng giờ đến nhiều ngày sẽ hưởng lợi rõ nhất. Với một máy GPU hoặc workload suy luận ngắn có cơ chế thử lại ở tầng ứng dụng, hệ thống phục hồi toàn cụm có thể vượt nhu cầu. Hãy bắt đầu từ chi phí gián đoạn thực tế và số lần can thiệp thủ công mỗi tháng.
Mission Control 2.5 có thay thế checkpoint không?
Không. Hệ thống hỗ trợ phát hiện và khôi phục, nhưng checkpoint vẫn quyết định lượng công việc có thể tiếp tục sau sự cố.
Có dùng được với Kubernetes không?
Có. Phiên bản 2.5 mở rộng động cơ phục hồi sang workload Kubernetes được quản lý bằng NVIDIA Run:ai.
Phát hiện bất thường mạng đã ổn định chưa?
NVIDIA ghi rõ tính năng phát hiện bất thường mạng bằng AI đang ở trạng thái beta, nên cần kiểm thử trước khi dựa vào nó cho vận hành quan trọng.
Nguồn tham khảo
Nếu đội nền tảng đang chuẩn bị chạy Kubernetes trên cụm GPU, hãy gửi số node, loại GPU, phiên bản Kubernetes, bộ lập lịch, framework và chính sách checkpoint tới hotro@thuemaychu.vn. Thông tin này giúp xây dựng bài thử phục hồi thực tế trước khi áp dụng tự động hóa rộng hơn.
Cần máy chủ cho workload này?
NOC thuemaychu.vn hỗ trợ chọn CPU, GPU và băng thông. PoC trong 24 giờ.
Bài viết liên quan
 Bảo mật
Hai CVE Kubernetes mới: kiểm tra quyền StatefulSet và Windows node
Kubernetes vừa đưa CVE-2026-2270 và CVE-2026-76654 vào nguồn CVE chính thức. Bài dành cho quản trị cụm cần xác định đúng thành phần bị ảnh hưởng, ưu tiên nâng cấp và kiểm tra quyền trước khi thay đổi hệ thống.
 GPU / AI
Cụm 8 DGX Spark chạy mô hình 753B: đọc đúng benchmark NVIDIA
NVIDIA công bố ngày 22/10/2026 rằng tám DGX Spark có thể ghép thành cụm 1TB bộ nhớ hợp nhất. Các con số hiệu năng là benchmark của hãng.
 GPU / AI
NVIDIA OpenShell: kiến trúc bảo vệ AI Agent có gì đáng chú ý?
NVIDIA giới thiệu kiến trúc tham chiếu OpenShell ngày 21/10/2026. Bài viết giải thích cách cô lập AI Agent, quản lý khóa truy cập và thử nghiệm trước khi triển khai.