NVIDIA Reshard Collective giảm thời gian cập nhật trọng số khi hậu huấn luyện LLM
Reshard Collective chuyển đúng phần trọng số mà GPU suy luận cần, thay vì gom rồi phát toàn bộ. Bài viết phân tích benchmark hãng và điều kiện thử nghiệm.
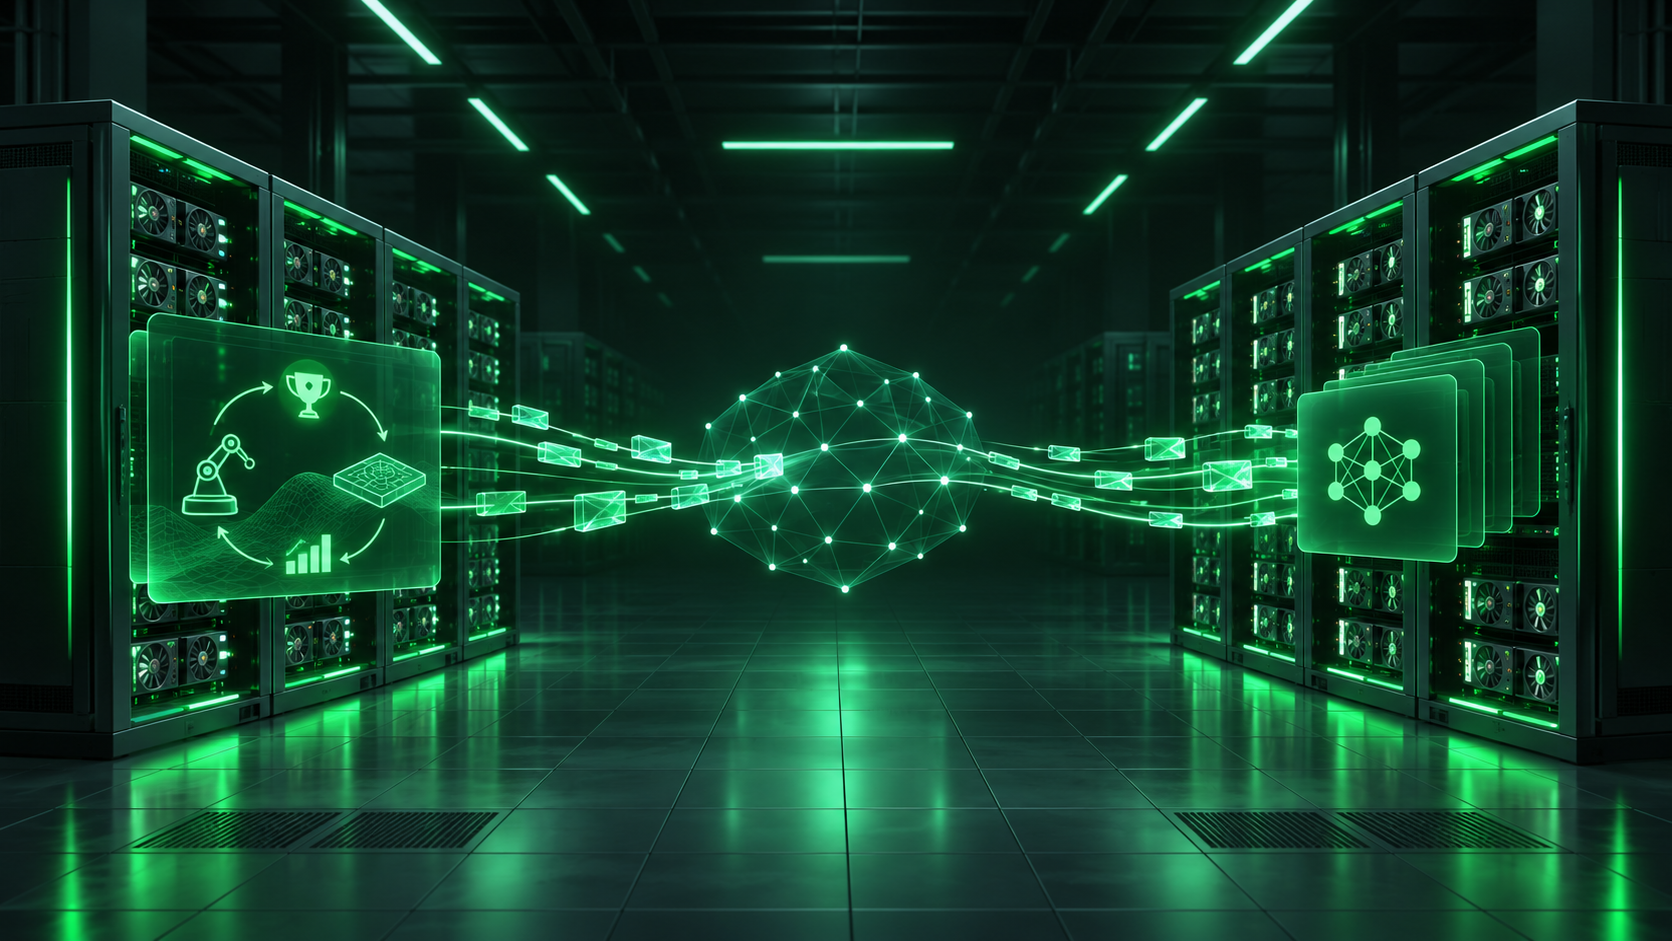
Một đội AI tách cụm GPU huấn luyện khỏi cụm GPU sinh dữ liệu thường gặp khoảng dừng khó chịu: sau mỗi bước học tăng cường, trọng số mới phải được chuyển sang phía suy luận trước khi tạo lượt dữ liệu tiếp theo. Ngày 06/11/2026, NVIDIA giới thiệu Reshard Collective và bản tham chiếu mã nguồn mở NCCL M2N Reshard để giảm phần truyền dữ liệu thừa trong bước này.
Điều mới nằm ở đường đi của trọng số
Trong hậu huấn luyện bằng học tăng cường, hay RL post-training, mô hình chính sách liên tục được cập nhật. “Refit” là thao tác đưa trọng số vừa cập nhật từ GPU huấn luyện sang GPU suy luận. Hai phía thường chia mô hình theo cách khác nhau, nên cách phổ biến là gom đầy đủ từng tham số rồi phát lại cho mọi GPU đích.
Theo bài kỹ thuật NVIDIA ngày 06/11/2026, cách gom rồi phát khiến GPU đích nhận cả phần dữ liệu không cần. Reshard mô tả bố cục nguồn và đích bằng DTensor, tức tensor phân tán của PyTorch, sau đó tính đúng phần giao nhau giữa từng mảnh để chuyển trực tiếp.
Con số 2,7–5,7 lần cần được đọc thế nào?
NVIDIA đo riêng thời gian refit trên DGX H100 và DGX GB200. Trong các cấu hình thử với Qwen 3 235B, DeepSeek v3 671B và Nemotron Ultra v3, Reshard nhanh hơn cách gather-and-broadcast từ 2,7 đến 5,7 lần. Ví dụ do hãng công bố, DeepSeek v3 671B trên DGX H100 giảm từ 14,9 giây xuống 2,6 giây.
Đây là benchmark của NVIDIA, không phải cam kết cho mọi cụm. Kết quả phụ thuộc số GPU, cách chia tensor, expert và pipeline, băng thông giữa nút, miền NVLink, phiên bản NeMo RL và tỷ lệ thời gian refit trong toàn bộ vòng lặp. Nếu nút thắt thực tế nằm ở sinh dữ liệu, chấm thưởng hoặc lưu trữ, mức tăng của toàn tác vụ sẽ thấp hơn.
Khi nào kiến trúc này đáng thử?
- Đội đang chạy hậu huấn luyện RL với cụm huấn luyện và suy luận tách rời.
- Mô hình lớn khiến mỗi lần đồng bộ trọng số chiếm tỷ lệ đáng kể trong thời gian bước.
- Bố cục song song giữa hai phía khác nhau và hiện phải dựng lại tham số đầy đủ.
- Hạ tầng có NCCL, PyTorch DTensor và kết nối GPU đủ ổn định để đo riêng lưu lượng liên nút.
Thiết kế hiện tại trong NeMo RL dùng Reshard cho các trọng số chiếu feed-forward, nhóm mà NVIDIA nói chiếm khoảng 95% tham số ở các LLM mới, còn các trọng số nhỏ vẫn đi theo cách cũ để giữ độ phủ chức năng. Khả năng thay đổi nhóm giao tiếp bằng API shrink/grow mới là lộ trình; NeMo RL hiện tạo lại nhóm khi thành viên GPU thay đổi.
Checklist thử nghiệm không làm gián đoạn cụm
- Ghi lại thời gian từng pha: sinh dữ liệu, tính thưởng, cập nhật, refit và checkpoint.
- Chọn một mô hình đại diện, cố định batch, độ chính xác số và bố cục song song.
- Đo lưu lượng liên nút, thời gian refit và độ chính xác trọng số với cách hiện tại.
- Bật
refit_transport: nccl_reshardtrong môi trường thử nghiệm theo hướng dẫn NeMo RL; không đổi đồng thời driver, NCCL và topology. - Chạy đủ nhiều bước, mô phỏng mất một nút và kiểm tra quá trình tạo lại communicator.
- Chỉ mở rộng khi thời gian toàn vòng lặp giảm, không chỉ microbenchmark refit đẹp hơn.
Tác động với đội thuê GPU tại Việt Nam
Giá trị thực tế không phải “một GPU chạy nhanh hơn”, mà là giảm thời gian các GPU đắt tiền chờ nhau trong hậu huấn luyện phân tán. Đội thuê cụm theo giờ nên yêu cầu nhà cung cấp mô tả rõ topology NVLink/NVSwitch, mạng giữa nút, phiên bản driver và khả năng giữ nguyên nhóm máy trong suốt bài chạy. Những thông tin này quyết định liệu benchmark có tái lập được hay không.
Nếu cần thiết kế bài thử, đội AI có thể gửi số GPU, loại mô hình, sơ đồ song song và log thời gian từng pha qua kênh liên hệ của Thuê Máy Chủ. Mục tiêu là xác định nút thắt và cấu hình thử phù hợp trước khi tăng quy mô, không suy đoán hiệu năng từ tên GPU.
Reshard Collective có làm mô hình chính xác hơn không?
Không. Đây là cơ chế truyền và sắp xếp lại trọng số giữa các bố cục GPU. Đội triển khai vẫn phải kiểm tra tính toàn vẹn trọng số và kết quả mô hình.
Có áp dụng cho suy luận LLM thông thường không?
Giá trị chính nằm ở vòng lặp hậu huấn luyện RL tách cụm huấn luyện và suy luận. Dịch vụ suy luận chỉ nạp mô hình một lần thường không được lợi tương tự.
Có thể coi mức tăng 5,7 lần là hiệu năng toàn tác vụ không?
Không. Đó là mức tăng trong benchmark refit của NVIDIA. Hiệu năng toàn vòng lặp phụ thuộc nhiều pha khác.
Nguồn tham khảo
NVIDIA Technical Blog, “Accelerating Reinforcement Learning Weight Refit with the Reshard Collective”, đăng và công bố ngày 06/11/2026; tài liệu NeMo RL và NCCL Reshard được liên kết trực tiếp trong bài gốc.
Cần máy chủ cho workload này?
NOC thuemaychu.vn hỗ trợ chọn CPU, GPU và băng thông. PoC trong 24 giờ.
Bài viết liên quan
 GPU / AI
CUDA 13.5 thay đổi cách chia sẻ GPU với MPS v3
CUDA 13.5 hỗ trợ chính thức kiến trúc Vera Rubin, đồng thời bổ sung nhiều cơ chế điều phối MPS v3. Bài viết phân tích giá trị thực tế, điều kiện áp dụng và cách thử nghiệm an toàn.
 GPU / AI
Vera Rubin tối ưu HBM và KV cache cho suy luận AI ra sao?
NVIDIA cho rằng hiệu quả suy luận không chỉ phụ thuộc dung lượng HBM mà còn ở độ chính xác số, cách phân bổ mô hình, định tuyến KV cache và tầng lưu trữ.
 GPU / AI
NVIDIA Attribution: tìm nguyên nhân lỗi trong cụm GPU phân tán
NVIDIA Attribution gom bằng chứng theo từng tác vụ để phân biệt lỗi gốc với chuỗi lỗi NCCL, GPU và mạng phát sinh sau đó.