NVIDIA Attribution: tìm nguyên nhân lỗi trong cụm GPU phân tán
NVIDIA Attribution gom bằng chứng theo từng tác vụ để phân biệt lỗi gốc với chuỗi lỗi NCCL, GPU và mạng phát sinh sau đó.
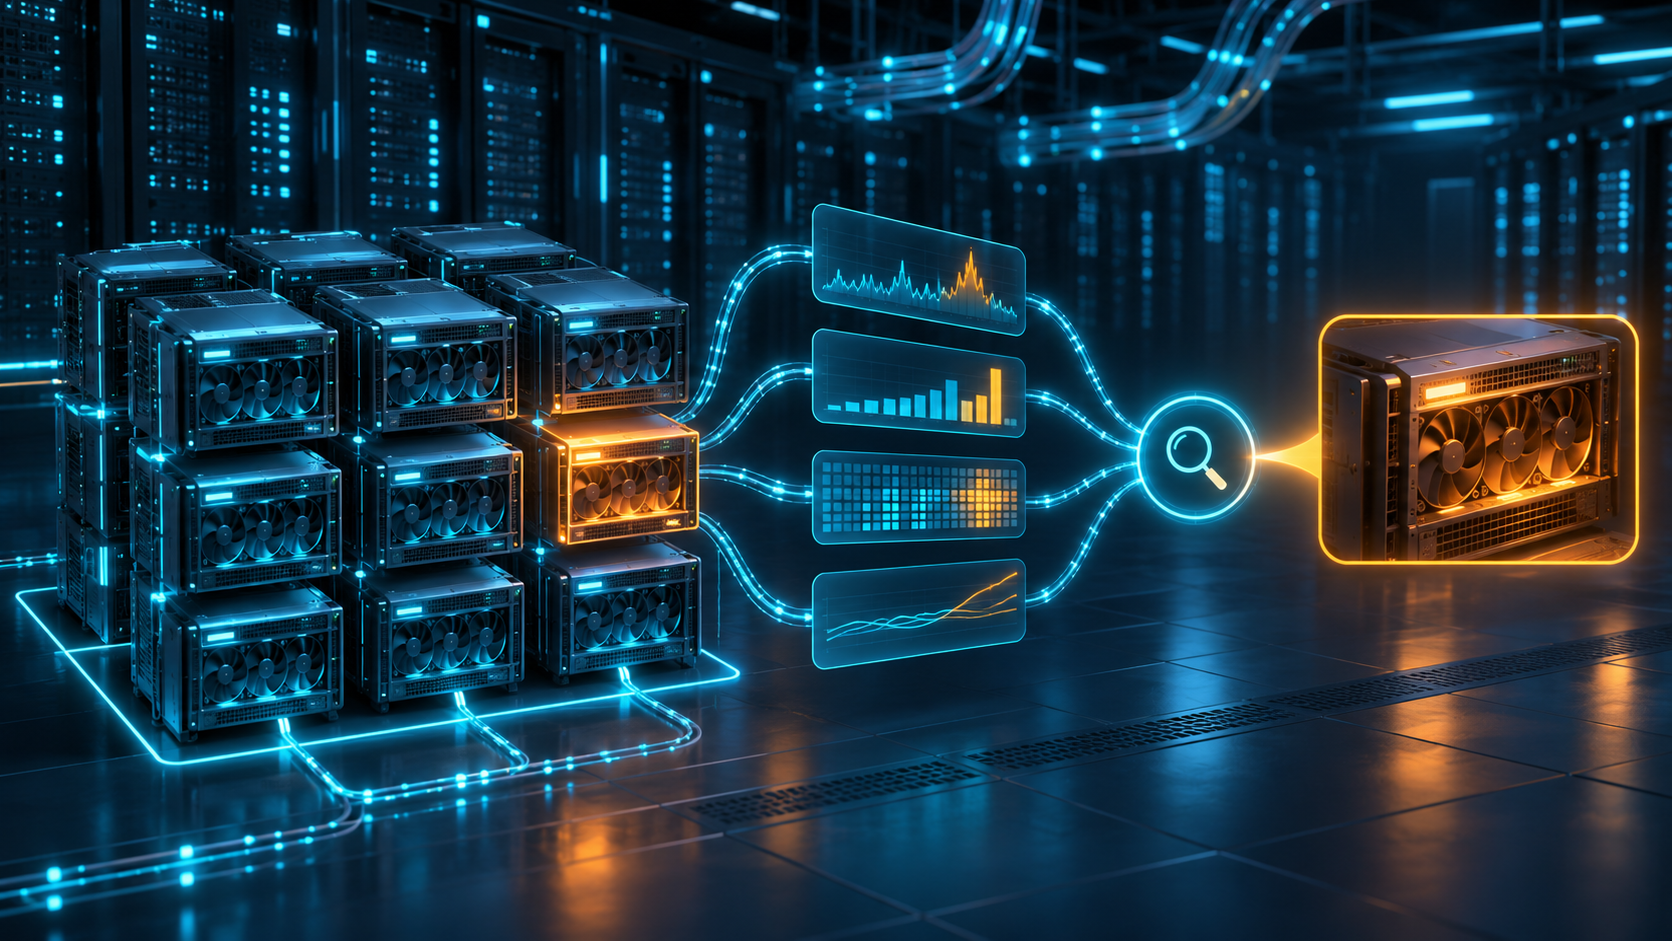
Một tác vụ huấn luyện chạy trên nhiều máy có thể dừng vì một GPU, một cổng mạng hoặc một liên kết NVLink gặp sự cố. Nhưng trên màn hình, đội vận hành thường chỉ thấy hàng nghìn lỗi NCCL ở nhiều tiến trình. Ngày 02/11/2026, NVIDIA công bố Attribution dưới dạng mã nguồn mở để gom các dấu vết đó thành một chẩn đoán có thể kiểm tra lại. Bài này dành cho đội vận hành cụm GPU và MLOps cần rút ngắn thời gian tìm nguyên nhân, không phải cho người dùng một GPU đơn lẻ.
Điểm mới trong công bố ngày 02/11/2026
Theo NVIDIA Technical Blog, Attribution phân tích từng lần chạy của một workload, tức tác vụ có phạm vi và thời gian xác định. Công cụ kết hợp log ứng dụng, syslog, thông báo trình điều khiển GPU, trạng thái bộ lập lịch và chỉ số mạng. Kết quả gồm trạng thái cuối, miền lỗi, nút bị ảnh hưởng, triệu chứng và đường dẫn bằng chứng.
Hệ thống có hai phần. Attribution Service cung cấp API HTTP cho bộ máy luật; Attribution Blueprint là bộ điều phối tham chiếu bằng Python, có đầu nối cho Slurm, Kueue, đầu vào tĩnh, Loki, log pod Kubernetes, tệp cục bộ và chỉ số PromQL. Đây là thành phần tự triển khai, không đồng nghĩa với một dịch vụ quản trị sẵn.
NVIDIA cho biết hệ thống đã phân tích hàng triệu workload mỗi tuần trên hàng trăm nghìn GPU trong hạ tầng nội bộ. Đây là số liệu do hãng công bố, không phải benchmark độc lập và không dự đoán chính xác hiệu quả trên cụm khác.
Vì sao lỗi NCCL chưa chắc là nguyên nhân gốc
NCCL là thư viện giao tiếp giữa GPU. Khi một nút mất liên kết hoặc GPU phát ra mã XID, các tiến trình còn lại có thể cùng báo lỗi giao tiếp. Nếu chỉ đếm thông báo cuối cùng, đội vận hành dễ thay nhầm card hoặc khởi động lại cả cụm. Ví dụ của NVIDIA dùng XID 149 trên một nút để xác định lỗi toàn vẹn tín hiệu NVLink, còn các lỗi NCCL trên nút khác được giữ lại như triệu chứng hỗ trợ.
Attribution dùng luật xác định thay vì mô hình ngôn ngữ để đưa ra kết luận. Lợi thế là cùng một bộ bằng chứng cho kết quả có thể tái tạo. Hạn chế cũng rõ: nếu log thiếu, đồng hồ giữa các nút lệch hoặc Prometheus không giữ đủ dữ liệu, trường nguyên nhân có thể vẫn ở trạng thái mơ hồ.
Tác động với đội thuê GPU tại Việt Nam
Với cụm nhiều máy, chi phí lớn không chỉ nằm ở thời gian GPU ngừng chạy mà còn ở thời gian kỹ sư lần theo log. Attribution có thể bổ sung lớp giải thích giữa hệ thống giám sát và quy trình phục hồi. Nó không thay thế theo dõi nhiệt độ, ECC, XID, mạng RDMA hay checkpoint. Đội dùng dịch vụ GPU cần xác nhận mình có quyền truy cập log máy chủ, bộ lập lịch và dữ liệu mạng cần thiết trước khi tính đến tích hợp.
Checklist thử nghiệm an toàn
- Chọn một workload thử nghiệm có mã tác vụ, khoảng thời gian và danh sách nút rõ ràng.
- Kiểm tra thời gian trên các nút được đồng bộ; xác định thời hạn lưu log và chỉ số.
- Chạy quickstart với dữ liệu mẫu trước, sau đó kết nối một nguồn log không nhạy cảm.
- So sánh kết luận của Attribution với biên bản sự cố cũ; không tự động cô lập nút ngay từ lần đầu.
- Quy định quyền đọc log, ẩn khóa truy cập và dữ liệu người dùng trước khi đưa vào pipeline.
- Chỉ kết nối hệ thống phục hồi sau khi đo tỷ lệ kết luận đúng, sai và mơ hồ.
Cách chọn bước tiếp theo
Cụm nhỏ có thể bắt đầu bằng dashboard đọc-only và SQLite. Cụm nhiều hàng đợi nên chuẩn hóa mã workload, nút cấp phát và đường dẫn log trước khi thêm luật. Nếu đang dùng Slurm hoặc Kueue, hãy kiểm tra đầu nối hiện có; Kubernetes thuần cần xác định cách ánh xạ Job, pod và lần thử lại thành một execution context.
NVIDIA Attribution có tự sửa lỗi GPU không?
Không. Công cụ tập trung xác định nguyên nhân và xuất bằng chứng có cấu trúc. Việc cô lập nút, sửa hạ tầng hoặc khởi động lại workload cần hệ thống khác và chính sách riêng.
Công cụ có thay Prometheus hoặc Loki không?
Không. Nó có thể đọc chỉ số PromQL và log Loki, nhưng vẫn cần nguồn quan sát đáng tin cậy.
Có phù hợp với một máy chủ GPU không?
Có thể dùng, nhưng giá trị lớn nhất xuất hiện ở workload phân tán, nơi lỗi từ một nút tạo triệu chứng trên nhiều tiến trình.
Nguồn tham khảo
Nếu đội AI đang gặp lỗi lặp lại trên nhiều GPU, hãy chuẩn bị loại GPU, bộ lập lịch, số nút, mã XID/NCCL, khoảng thời gian sự cố và cách lưu log. Gửi các thông tin đó qua kênh liên hệ trên thuemaychu.vn để trao đổi phạm vi kiểm tra hạ tầng và phương án thử nghiệm phù hợp; chưa cần nâng cấu hình khi nguyên nhân chưa được xác định.
Cần máy chủ cho workload này?
NOC thuemaychu.vn hỗ trợ chọn CPU, GPU và băng thông. PoC trong 24 giờ.
Bài viết liên quan
 GPU / AI
NVIDIA Minerva: phát hiện nút chậm và tăng hiệu suất cụm GPU
Minerva dùng đồ thị quan hệ và mô hình học máy để liên kết sự cố với workload GPU. Bài viết giúp đội vận hành đọc đúng số liệu hãng và lập kế hoạch thử nghiệm.
 GPU / AI
NVIDIA Mission Control 2.5: tự phục hồi job GPU trên Kubernetes
Mission Control 2.5 phối hợp bộ lập lịch, phục hồi job và chẩn đoán phần cứng để giảm thời gian gián đoạn cho cụm GPU Kubernetes.
 GPU / AI
Backup checkpoint và dữ liệu trên GPU Server
Dữ liệu trên GPU Server có thể gồm checkpoint tải về, dataset riêng, trọng số tinh chỉnh, cấu hình và kết quả chạy. Khi kết thúc thuê hoặc máy lỗi, mất một artifact nhỏ nhưng không thể tái tạo có thể làm mất nhiều giờ tính toán.