NVIDIA H200 NVL: thông số, phiên bản và mô hình AI
H200 NVL đưa 141 GB HBM3e trên mỗi GPU vào cấu hình PCIe. Đội phục vụ mô hình lớn có thể hưởng lợi từ dư địa bộ nhớ, nhưng vẫn phải đo độ trễ và tải đồng thời.
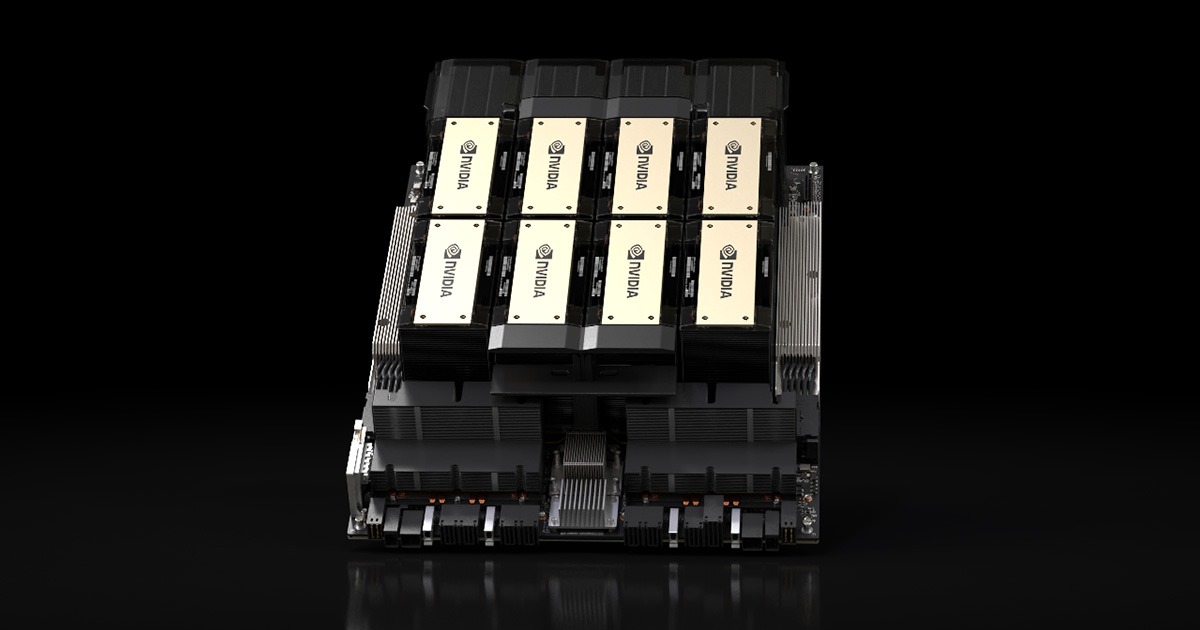
H200 NVL đưa 141 GB HBM3e trên mỗi GPU vào cấu hình PCIe. Đội phục vụ mô hình lớn có thể hưởng lợi từ dư địa bộ nhớ, nhưng vẫn phải đo độ trễ và tải đồng thời.
Thông số được đối chiếu ngày 09/10/2026. Các mô hình dưới đây là gợi ý để kiểm thử theo bộ nhớ, chưa phải kết quả đo trên máy thuê tại Datahub DC.
Thông số cần biết trước khi chọn NVIDIA H200 NVL
| Hạng mục | Thông số công bố |
|---|---|
| Kiến trúc | Hopper |
| Bộ nhớ trên mỗi GPU | 141 GB HBM3e mỗi GPU |
| Công suất GPU | Tối đa 600 W |
| Nhóm sản phẩm | GPU máy chủ/data center |
| Băng thông bộ nhớ | 4,8 TB/s |
VRAM là bộ nhớ riêng của GPU, dùng chứa trọng số mô hình, dữ liệu đang xử lý và vùng làm việc. Băng thông bộ nhớ cho biết tốc độ trao đổi dữ liệu với VRAM; dung lượng lớn và băng thông cao là hai đặc tính khác nhau.
Phiên bản nào đang được nhắc tới?
Mỗi H200 NVL có 141 GB, tối đa 600 W; SXM cũng 141 GB nhưng kiểu lắp và giới hạn điện khác. Tổng 2/4 GPU là bộ nhớ phân bố, không tự gộp cho mọi ứng dụng.
Công nghệ đáng chú ý và giới hạn
Hopper kết hợp HBM3e và Transformer Engine. Dung lượng lớn giúp giữ trọng số và bộ nhớ hội thoại trong GPU, giảm áp lực chuyển dữ liệu khi cấu hình phù hợp.
Khi so thông số AI, phải kiểm tra định dạng số và điều kiện đo. FP16 dùng 16 bit cho mỗi giá trị; FP8/FP4 dùng ít bit hơn nhưng cần phần cứng, định dạng mô hình và phần mềm phù hợp. Số TOPS hay TFLOPS không tự chuyển thành số câu hỏi chatbot xử lý mỗi giây.
Những mô hình AI nên đưa vào danh sách thử
Trong tên model, B là tỷ tham số: 7B có quy mô khoảng 7 tỷ tham số. Suy luận là dùng mô hình đã huấn luyện để trả kết quả. Vector tìm kiếm là dãy số biểu diễn ý nghĩa văn bản hoặc hình ảnh để tìm nội dung gần nhau.
70B nén 4-bit có thêm dư địa để khảo sát. Với 70B FP16, khoảng 140 GB chỉ cho trọng số lý tưởng đã gần đầy 141 GB, nên không coi một card là cấu hình phục vụ an toàn.
| Quy mô mô hình | Trọng số FP16 lý tưởng | Trọng số 4-bit lý tưởng | Cách đọc |
|---|---|---|---|
| 32B | 64 GB | 16 GB | FP16 cần dư địa ngoài trọng số; thử đúng độ dài đầu vào. |
| 70B | 140 GB | 35 GB | Một GPU dưới 140 GB không chứa FP16 đầy đủ; bản nén cần kiểm tra thêm. |
Phép tính trên là số tham số × số bit / 8. Mô hình nén còn có thông tin phục vụ giải nén; phần mềm cần vùng làm việc. KV cache là bộ nhớ lưu trạng thái cuộc hội thoại để tránh tính lại dữ liệu cũ, tăng theo độ dài đầu vào và số phiên. Vì vậy một mô hình nạp được chưa chứng minh máy phục vụ ổn định.
Ví dụ để thử có thể lấy Qwen2.5-32B hoặc Llama 3.1 70B với định dạng vừa bộ nhớ. Đây là các model có tài liệu công khai, không phải danh sách model mới nhất. Tinh chỉnh bằng LoRA/QLoRA là huấn luyện phần tham số bổ sung theo cách tiết kiệm bộ nhớ; nhu cầu khác chạy suy luận, nên không dùng bảng trên để kết luận đủ VRAM huấn luyện.
Cách kiểm thử trước khi thuê dài hạn
Xác minh số GPU, cầu NVLink, nguồn và khả năng làm mát. Đo thời gian trả token đầu cùng tải nhiều người dùng.
- Chốt tên và phiên bản mô hình, định dạng trọng số, môi trường chạy; kiểm tra driver và thư viện có hỗ trợ GPU.
- Lấy dữ liệu đại diện, gồm cả tài liệu dài nhất và đầu ra cần tạo. Chạy thử một phiên rồi tăng dần số phiên đồng thời.
- Ghi đỉnh VRAM, thời gian trả kết quả đầu tiên, tốc độ hoàn thành và lỗi hết bộ nhớ. Đo lại khi chạy đủ các dịch vụ trên máy.
- Thử tải kéo dài, theo dõi nhiệt độ và điện; so tổng chi phí hoàn thành công việc với cấu hình thay thế.
So với thế hệ mới và card gần nhất
So với H100 NVL 94 GB và H200 SXM theo kiểu máy; các nền tảng Blackwell/Rubin cần tính cả rack.
Tư vấn cấu hình cho đội vận hành máy chủ AI
Nếu đội vận hành máy chủ AI đang chọn GPU cho dự án, hãy gửi tên model, định dạng chạy, độ dài dữ liệu đầu vào, số người dùng đồng thời và ngân sách tới hotro@thuemaychu.vn hoặc gọi 028.888.70979. Datahub DC có thể trao đổi cấu hình và phương án kiểm thử; cần xác nhận riêng card sẵn có, giá và phạm vi hỗ trợ trước khi chốt.
NVIDIA H200 NVL có những phiên bản bộ nhớ nào?
Mỗi H200 NVL có 141 GB, tối đa 600 W; SXM cũng 141 GB nhưng kiểu lắp và giới hạn điện khác. Tổng 2/4 GPU là bộ nhớ phân bố, không tự gộp cho mọi ứng dụng.
Các mô hình gợi ý đã được đo hiệu năng chưa?
Chưa. Bài đưa ra ứng viên kiểm thử và phép tính trọng số lý tưởng. Cần đo trên đúng GPU, phần mềm, định dạng mô hình, độ dài đầu vào và tải đồng thời.
Có thể thuê ngay NVIDIA H200 NVL tại Datahub DC không?
Bài mô tả sản phẩm, không xác nhận tồn kho. Liên hệ hotro@thuemaychu.vn hoặc 028.888.70979 để kiểm tra cấu hình sẵn có và báo giá.
Cần máy chủ cho workload này?
NOC thuemaychu.vn hỗ trợ chọn CPU, GPU và băng thông. PoC trong 24 giờ.
Bài viết liên quan
 GPU / AI
GPU NVIDIA mới nhất 2026: Rubin, Blackwell Ultra và RTX PRO
Chọn GPU NVIDIA mới nhất cho AI cần bắt đầu từ nhóm sản phẩm và công việc cần chạy. GPU trong máy trạm, GPU data center và một rack AI hoàn chỉnh phục vụ những yêu cầu khác nhau. Bài tổng quan này giúp doanh nghiệp lập danh sách đánh giá mà không đánh đồng tên kiến trúc với một cấu hình có thể thuê ngay.
 GPU / AI
GPU Server là gì? Cách chọn GPU cho mô hình ngôn ngữ lớn
Hướng dẫn chọn GPU Server theo workload: bộ nhớ, độ trễ, tải đồng thời và khả năng vận hành ứng dụng AI.
 GPU / AI
Cần bao nhiêu VRAM để chạy Llama 3.1 70B?
Tính riêng trọng số, KV cache và overhead; ví dụ context 8K, 32K và 128K với cache FP16.