MiTAC tách prefill và decode để chạy mô hình AI lớn
MiTAC đề xuất dùng AMD MI350X cho bước đọc đầu vào và bộ tăng tốc riêng để sinh câu trả lời. Xem khi nào đội AI nên thử tách hai bước.
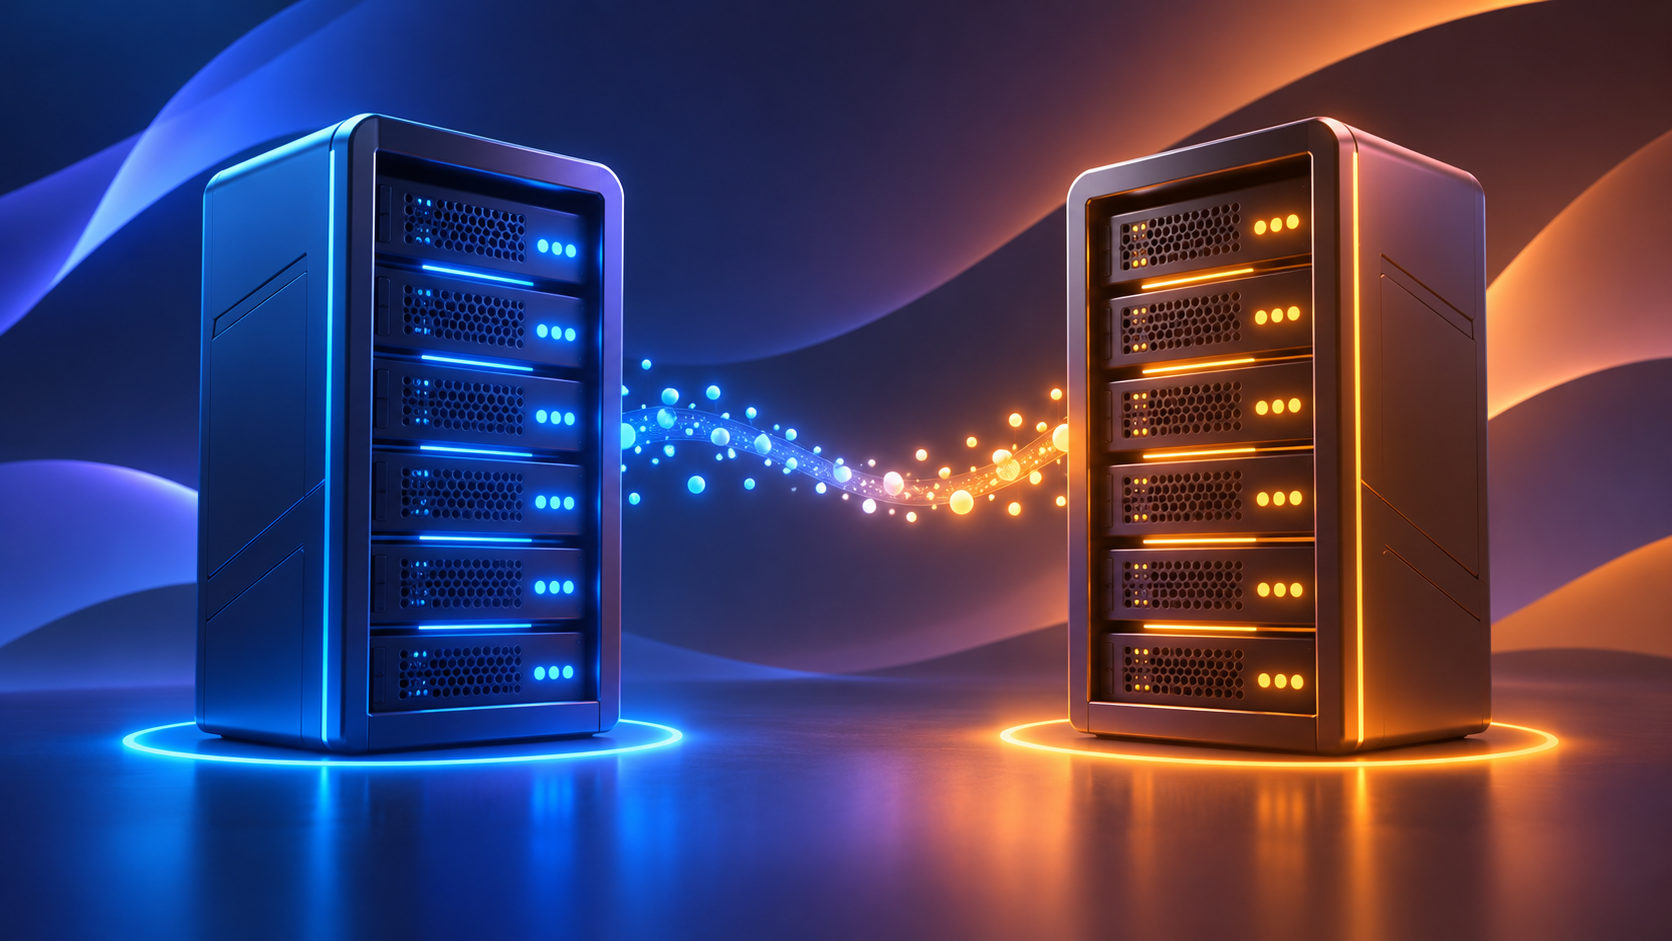
Chatbot nội bộ trả lời nhanh khi câu hỏi ngắn, nhưng khi người dùng đưa cả hồ sơ vào, họ phải chờ lâu mới thấy chữ đầu tiên. Nếu đội AI gặp tình huống này, hãy đo riêng thời gian đọc dữ liệu đầu vào và thời gian sinh câu trả lời. Tại SC26 ngày 17/11/2026, MiTAC công bố một thiết kế đặt hai bước đó trên hai máy chủ khác nhau.
MiTAC chia công việc giữa hai máy như thế nào?
Prefill là bước mô hình đọc câu hỏi và tài liệu đi kèm. Decode là bước sinh câu trả lời theo từng token, tức đơn vị văn bản mô hình xử lý. Giữa hai bước, máy giữ KV cache, vùng nhớ chứa kết quả trung gian từ phần văn bản đã đọc để tránh phải tính lại khi sinh token tiếp theo.
Theo thông cáo của MiTAC, phương án đề xuất dùng GPU AMD Instinct MI350X trong máy G8825Z5 cho prefill. Kết quả trung gian được gửi qua mạng tốc độ cao tới máy G4520G6 làm decode. Máy thứ hai dùng tám card Skymizer HTX301-4S, mỗi card có 256 GB bộ nhớ, tổng dung lượng hãng nêu là 2 TB. MiTAC lấy Kimi K3 làm ví dụ mô hình mục tiêu. Đây là cấu hình đề xuất tại triển lãm. Thông cáo chưa cho biết nó xử lý được bao nhiêu yêu cầu cùng lúc ở một ngưỡng thời gian phản hồi cụ thể.
Khi nào đội AI nên thử?
Nếu lưu lượng thay đổi mạnh theo độ dài tài liệu, tách hai bước cho phép tăng tài nguyên ở nơi thường xuyên phải xếp hàng. Một nhóm xử lý hồ sơ dài có thể cần thêm năng lực đọc đầu vào, trong khi dịch vụ viết báo cáo dài có thể cần dành tài nguyên cho khâu sinh văn bản nhiều hơn. Cùng một mô hình có thể gặp hai kiểu nghẽn vào hai khung giờ khác nhau.
Đổi lại, đường truyền giữa hai máy trở thành một phần của mỗi yêu cầu. Nếu thời gian chuyển vùng nhớ tăng vào giờ cao điểm, người dùng vẫn chờ dù cả hai máy đều còn tài nguyên. Đội vận hành cũng phải tính tới trường hợp một máy mất kết nối khi đang trả lời. Với chatbot ít người dùng hoặc lưu lượng ổn định, nên đo một cấu hình dùng chung tài nguyên trước để có mốc đối chiếu.
Cách thử trước khi thay đổi cấu hình
Chọn ba nhóm yêu cầu đại diện cho hệ thống: câu hỏi ngắn, câu hỏi kèm tài liệu dài và yêu cầu cần trả lời dài. Thử cả tải đều và một đợt nhiều người gửi đồng thời. Dùng cùng mô hình, cùng giới hạn đầu ra và cùng bộ câu hỏi khi so cấu hình. Đo từ phía ứng dụng, vì đó là nơi ghi nhận cả thời gian chờ lẫn thời gian truyền.
Ghi riêng thời gian đến đoạn trả lời đầu tiên, thời gian hoàn tất, số lượt đạt ngưỡng phục vụ và số lượt lỗi. Với cấu hình hai máy, theo dõi thêm thời gian chuyển KV cache và cách hệ thống xử lý khi khâu sinh văn bản bị quá tải. Chỉ tính một lượt thành công khi câu trả lời đạt tiêu chí chất lượng đã thống nhất. Một lần thử cho thấy tốc độ tốt nhưng câu trả lời kém có thể làm tăng số lượt người dùng phải hỏi lại.
Nếu cấu hình đơn vẫn đáp ứng giờ cao điểm, giữ nó làm phương án triển khai. Nếu cấu hình tách hai bước có thêm năng lực phục vụ ở cùng chất lượng, hãy so chi phí của cả hai máy, đường truyền và thời gian vận hành trên mỗi lượt đạt yêu cầu. Với khách thuê ở Việt Nam, hãy xác nhận kiểu kết nối giữa hai máy trước khi lập lịch thử.
Câu hỏi thường gặp
Tách hai bước có cần đúng card Skymizer không?
Cấu hình MiTAC nêu dùng card đó. Khi thử phương án khác, hãy xác nhận phần mềm phục vụ mô hình và khả năng chuyển vùng nhớ giữa hai máy.
Cộng bộ nhớ của hai máy để tính mô hình có chạy vừa được không?
Hãy tính theo từng bước. Mỗi máy cần chỗ cho dữ liệu nó xử lý, cùng phần bộ nhớ phần mềm giữ lại trong lúc phục vụ.
Nguồn tham khảo
Nếu đội AI đang bị chậm ở bước đọc tài liệu hoặc sinh câu trả lời, hãy gửi tên mô hình, độ dài đầu vào điển hình và số lượt đồng thời tới hotro@thuemaychu.vn để trao đổi cấu hình GPU phù hợp cho phép thử.
Cần máy chủ cho workload này?
NOC thuemaychu.vn hỗ trợ chọn CPU, GPU và băng thông. PoC trong 24 giờ.
Bài viết liên quan
 GPU / AI
AMD Enterprise AI 2.6: thử mô hình trên MI350P
AMD công bố các gói suy luận đầu tiên cho MI350P. Đội AI nên chọn đúng cấu hình trong danh mục và thử chất lượng, bộ nhớ, tải đồng thời trước khi chuyển.
 GPU / AI
NVIDIA chạy GLM-5.3 trên hai DGX Station với vLLM
NVIDIA trình bày cách chia GLM-5.3 NVFP4 qua hai GPU GB300. Đội AI cần đo thêm bộ nhớ phiên, thời gian chờ và lưu lượng giữa hai máy.
 GPU / AI
Vera Rubin tối ưu HBM và KV cache cho suy luận AI ra sao?
NVIDIA cho rằng hiệu quả suy luận không chỉ phụ thuộc dung lượng HBM mà còn ở độ chính xác số, cách phân bổ mô hình, định tuyến KV cache và tầng lưu trữ.