Oracle Acceleron và OCCL: mạng AI tự chuyển hướng khi lỗi
Oracle bổ sung RDMA front-end, mạng đa mặt phẳng và OCCL cho cụm AI. Bài viết giải thích tác động đến huấn luyện phân tán và cách kiểm thử trước khi áp dụng.
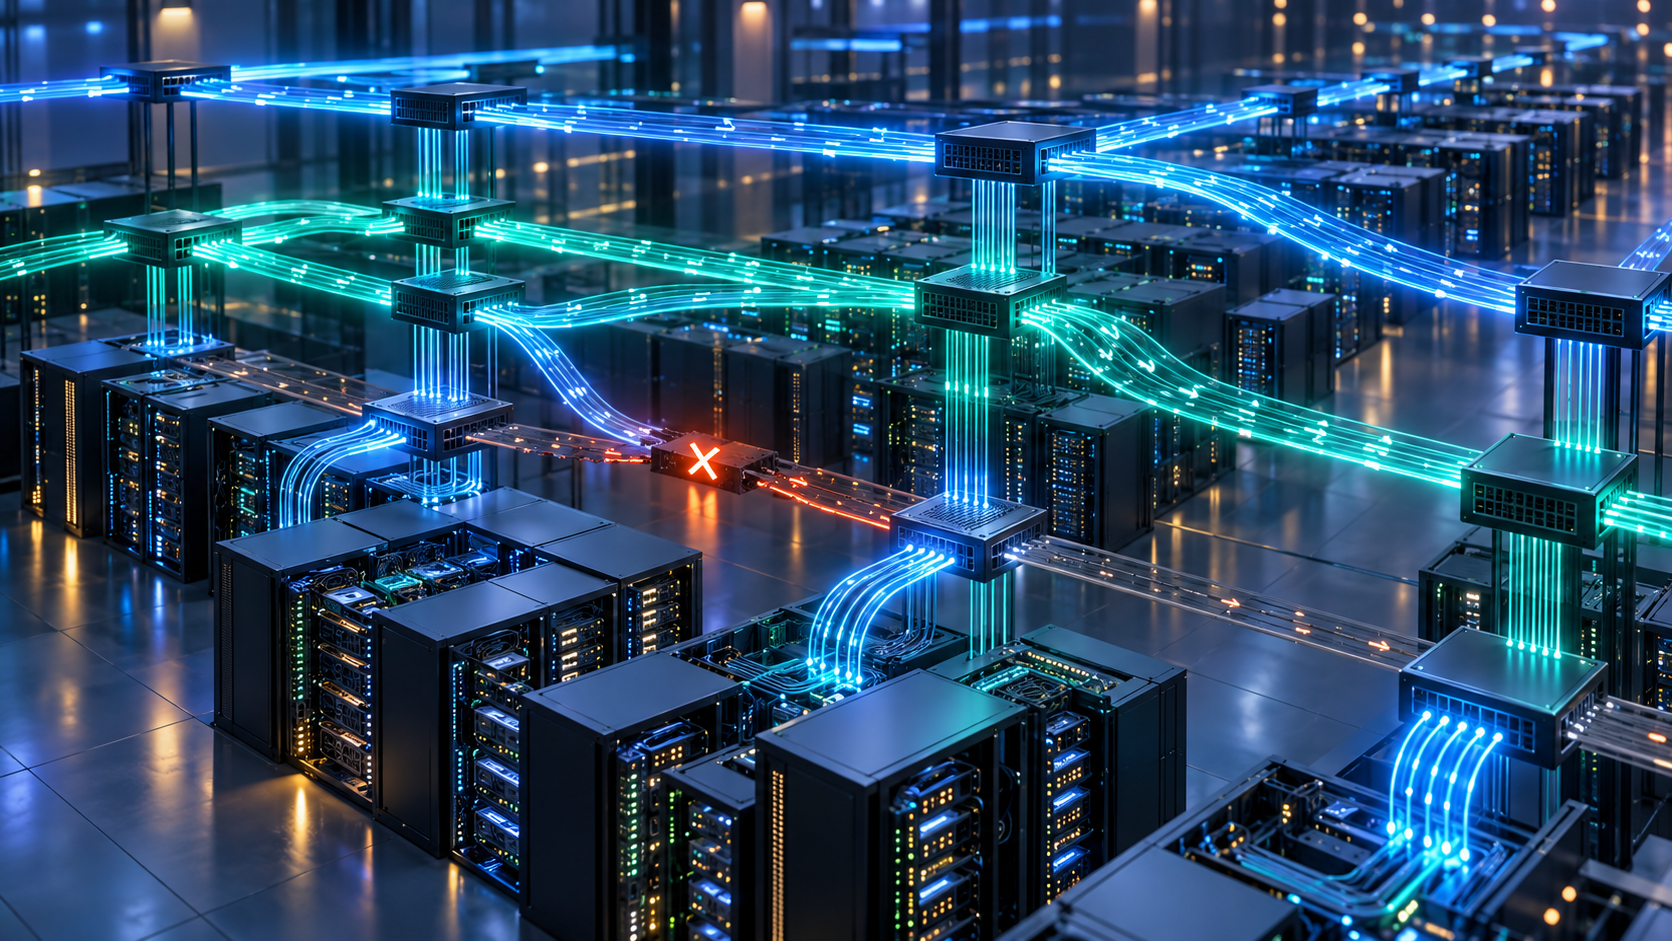
Trong huấn luyện phân tán, một liên kết nghẽn có thể khiến hàng trăm GPU cùng chờ. Oracle vừa công bố lớp mạng và plugin truyền thông tập thể nhằm phân phối lưu lượng qua nhiều mặt phẳng, tự chuyển sang đường khỏe khi phát hiện một số lỗi liên kết hoặc card mạng.
Thông cáo Oracle Acceleron được đăng và công bố tại Oracle AI World ngày 27/10/2026. Nguồn chính thức nêu bốn nhóm mới: RDMA ở mạng front-end, tùy chọn gắn NVMe block storage rộng hơn, Oracle Collective Communications Library và mạng front-end đa mặt phẳng.
OCCL đứng giữa framework và mạng như thế nào?
OCCL Network Plugin dùng giao diện plugin chuẩn của NCCL và RCCL. NCCL là thư viện trao đổi dữ liệu giữa GPU NVIDIA; RCCL làm vai trò tương tự cho GPU AMD. Plugin quan sát đường truyền RDMA, phân phối giao tiếp tập thể sang các mặt phẳng ít nghẽn và chuyển hướng khi gặp lỗi được hỗ trợ, không buộc ứng dụng huấn luyện thay đổi lời gọi collective.
Oracle cho biết bản OCCL ban đầu đã GA và dùng được trên các cấu hình RoCEv2 hoặc InfiniBand được hỗ trợ. GA không có nghĩa mọi loại máy, ảnh hệ điều hành hay vùng OCI đều tương thích; quản trị viên vẫn phải đối chiếu ma trận phiên bản.
Đọc đúng benchmark của Oracle
Trong thử nghiệm hãng trên hệ NVIDIA GB300 tháng 9/2026, plugin tăng bus bandwidth trung bình từ 2% đến 14,55% tùy phép collective và số nút. Mức cao nhất được báo cáo ở AllToAll 64 nút. Đây là benchmark của Oracle với thông điệp 1–16 GiB, 50 vòng đo và cấu hình cụ thể; không phải cam kết cho mọi cụm.
| Điểm cần đo | Vì sao quan trọng |
|---|---|
| AllReduce/AllToAll theo kích thước thông điệp | Mỗi mô hình tạo mẫu giao tiếp khác nhau. |
| p95 thời gian một bước huấn luyện | Thông lượng trung bình có thể che giấu đường chậm. |
| Thời gian phục hồi sau lỗi link/NIC | Xác nhận job tiếp tục thay vì chỉ chuyển lỗi sang lớp khác. |
| GPU utilization khi mạng nghẽn | Cho biết GPU có thực sự bớt chờ hay không. |
| Tính đúng sau failover | Phục hồi nhanh không được đổi kết quả mô hình. |
Tác động với cụm GPU và data center Việt Nam
Bài học có thể áp dụng ngoài OCI: với cụm nhiều nút, mạng không còn là phụ kiện của GPU. Đội hạ tầng cần thiết kế đường dự phòng, đo nghẽn theo hàng đợi và thử lỗi thật. Tuy nhiên tính năng OCCL cụ thể thuộc OCI; không nên suy ra cụm GPU tại Datahub đang dùng plugin này.
- Cụm một nút hoặc workload ít trao đổi dữ liệu sẽ khó hưởng lợi đáng kể.
- Huấn luyện đa nút, MoE và AllToAll nhạy với tail latency nên đáng kiểm thử hơn.
- Mạng đa mặt phẳng tăng khả năng phục hồi nhưng cũng tăng yêu cầu quan sát và quản lý phiên bản.
- Lưu trữ NVMe nhanh hơn chỉ có ích khi pipeline thực sự bị giới hạn I/O; cần đo trước khi nâng cấp.
Checklist triển khai an toàn
- Xác nhận GPU, NIC, switch, giao thức RDMA, image và phiên bản plugin nằm trong danh sách hỗ trợ.
- Chạy benchmark cơ sở khi chưa bật plugin, ghi cả trung bình và p95/p99.
- Bật plugin trong môi trường thử nghiệm; mô phỏng nghẽn, rút đường và lỗi NIC theo quy trình có kiểm soát.
- Theo dõi mất gói, retransmit, ECN, độ trễ từng đường, GPU utilization và checkpoint.
- Chỉ mở rộng khi kết quả có thể lặp lại với workload thật và có phương án quay lui.
Nguồn tham khảo
- Oracle, thông cáo Acceleron ngày 27/10/2026: https://www.oracle.com/news/announcement/ai-world-oracle-unveils-new-cloud-networking-innovations-for-ai-2026-10-27/
- Oracle OCI, bài OCCL ngày 26/10/2026: https://blogs.oracle.com/cloud-infrastructure/oci-occl-net-plugin
OCCL có thay thế NCCL hoặc RCCL không?
Không. OCCL là plugin mạng làm việc qua giao diện của NCCL/RCCL để phân phối đường và phục hồi một số lỗi.
Bật OCCL có chắc tăng 14% hiệu năng không?
Không. 14,55% là kết quả cao nhất trong một phép thử hãng; mức thực tế phụ thuộc mô hình, thông điệp và mạng.
Cụm GPU một máy có cần mạng đa mặt phẳng không?
Thường không phải ưu tiên đầu tiên vì phần lớn trao đổi nằm trong máy. Lợi ích rõ hơn ở huấn luyện đa nút.
Nếu bạn đang thiết kế cụm GPU đa nút, hãy gửi số nút, loại GPU, mô hình giao tiếp, kích thước dữ liệu và mục tiêu thời gian bước huấn luyện tới hotro@thuemaychu.vn. Các thông tin này giúp xác định bài đo mạng và lưu trữ trước khi chọn cấu hình.
Cần máy chủ cho workload này?
NOC thuemaychu.vn hỗ trợ chọn CPU, GPU và băng thông. PoC trong 24 giờ.
Bài viết liên quan
 GPU / AI
NVIDIA Minerva: phát hiện nút chậm và tăng hiệu suất cụm GPU
Minerva dùng đồ thị quan hệ và mô hình học máy để liên kết sự cố với workload GPU. Bài viết giúp đội vận hành đọc đúng số liệu hãng và lập kế hoạch thử nghiệm.
 GPU / AI
NVIDIA Mission Control 2.5: tự phục hồi job GPU trên Kubernetes
Mission Control 2.5 phối hợp bộ lập lịch, phục hồi job và chẩn đoán phần cứng để giảm thời gian gián đoạn cho cụm GPU Kubernetes.
 GPU / AI
Cụm 8 DGX Spark chạy mô hình 753B: đọc đúng benchmark NVIDIA
NVIDIA công bố ngày 22/10/2026 rằng tám DGX Spark có thể ghép thành cụm 1TB bộ nhớ hợp nhất. Các con số hiệu năng là benchmark của hãng.