Cloudflare lộ KV cache giữa yêu cầu LLM: bài học cho SGLang
Sự cố Workers AI cho thấy cấu hình context window lớn hơn vùng KV cache có thể kết hợp với lỗi SGLang để làm lộ dữ liệu giữa người dùng.
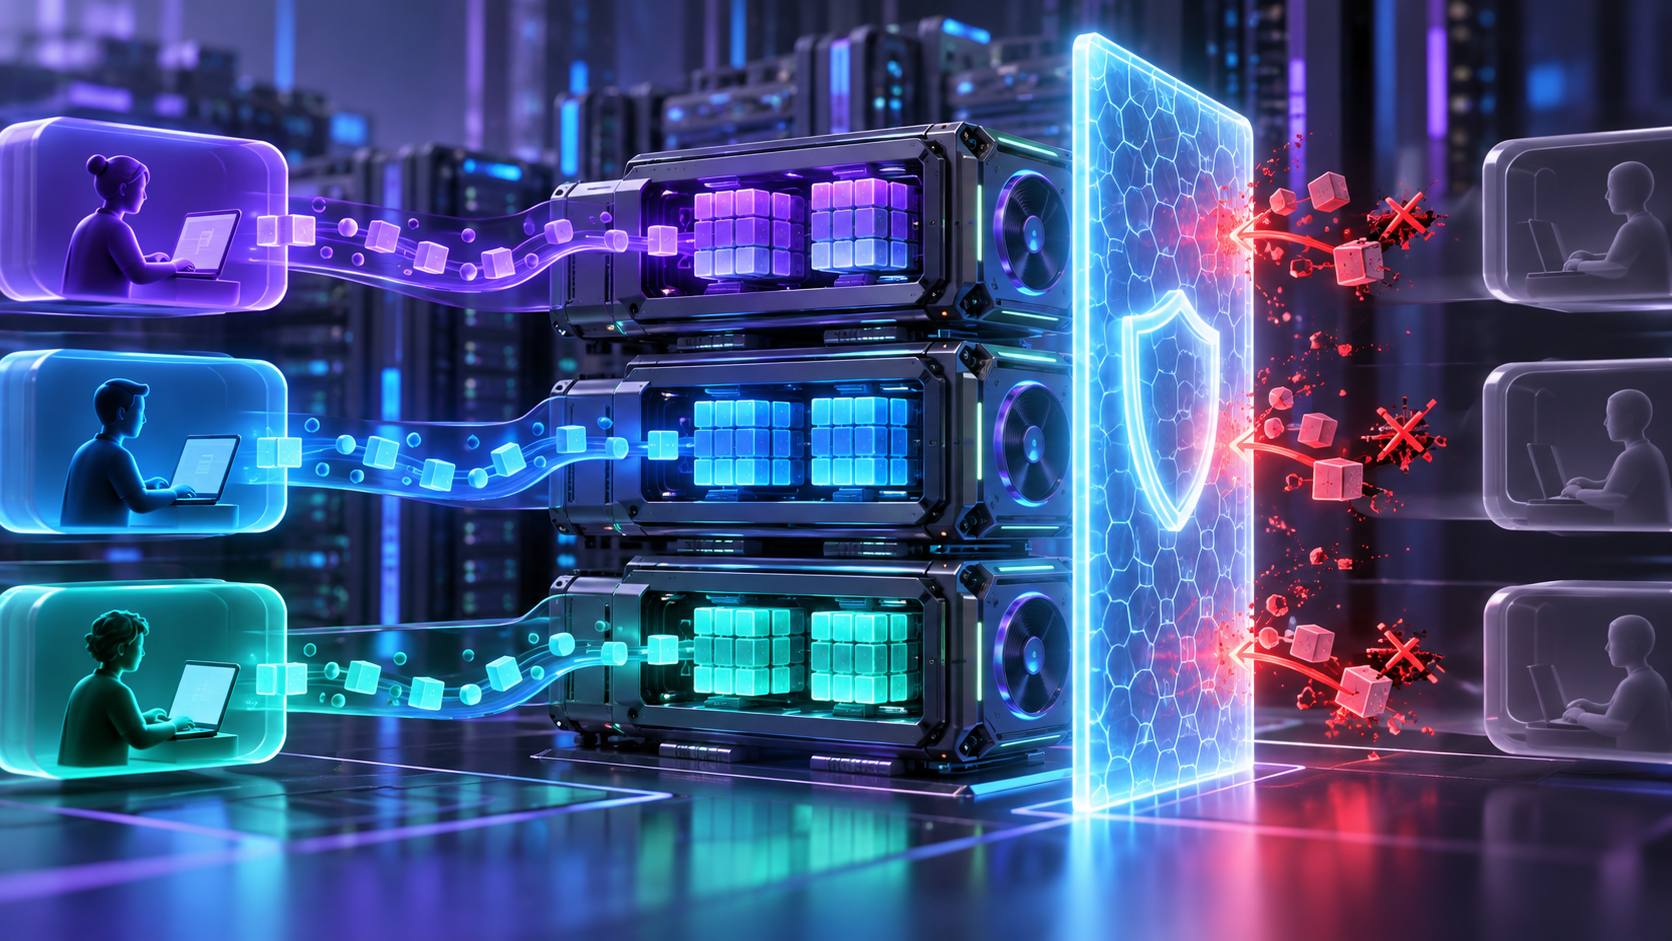
Một hệ thống LLM trả HTTP 200 không có nghĩa dữ liệu bên trong đúng và an toàn. Cloudflare vừa công bố sự cố trong đó một số phản hồi GLM-5.3 chứa nội dung từ yêu cầu của khách hàng khác. Với đội triển khai chatbot nhiều người dùng, đây là lời nhắc rằng bộ nhớ đệm GPU cũng là ranh giới bảo mật.
Báo cáo được Cloudflare đăng ngày 26/10/2026. Sự cố tồn tại từ 27/8 đến 9/9/2026 trên mô hình @cf/zai-org/glm-5.3 của Workers AI. Cloudflare xác định 155 phản hồi bị ảnh hưởng, đều liên quan prompt dài hơn 681.280 token. Hãng không tìm thấy bằng chứng khai thác có chủ đích và cho biết các mô hình khác không bị ảnh hưởng.
KV cache là gì và vì sao có thể lộ dữ liệu?
KV cache là vùng nhớ lưu trạng thái attention đã tính cho token trước đó, giúp mô hình không phải tính lại toàn bộ ngữ cảnh ở mỗi bước sinh. Trong cụm suy luận phân tán, một nhóm GPU xử lý prompt rồi chuyển KV cache sang nhóm GPU sinh câu trả lời. Nếu quyền sở hữu và vòng đời trang nhớ bị xử lý sai, yêu cầu mới có thể đọc trạng thái còn lại của yêu cầu cũ.
Theo Cloudflare, hệ thống đặt context window GLM-5.3 ở 1.048.576 token nhưng vùng KV cache trên GPU prefill chỉ chứa 681.280 token. Khi prompt vượt vùng nhớ, SGLang đánh dấu từ chối và thay prompt bằng một token giữ chỗ, nhưng vẫn báo cho node decode rằng việc chuyển cache đã hoàn tất.
Node decode vì thế giả định toàn bộ trang cache đã được ghi mới. Trên thực tế chỉ một phần nhỏ được ghi, phần còn lại vẫn chứa dữ liệu của yêu cầu trước. Đây là sự kết hợp giữa cấu hình không khớp và lỗi trong đường xử lý từ chối của chế độ prefill/decode tách rời.
Cloudflare và SGLang đã sửa thế nào?
- Tăng vùng KV cache để chứa đầy đủ context window hợp lệ; sau điều chỉnh, pool khoảng 2,04 triệu token.
- Chặn yêu cầu đã bị đánh dấu từ chối trước khi bootstrap, cấp phát hoặc chuyển KV cache.
- Để node decode xác minh số token nhận được khớp số token đã đặt chỗ.
- Thêm kiểm thử canary và đối chiếu trực tiếp kích thước KV pool với context window từ engine đang chạy.
- Đưa các bản sửa liên quan vào SGLang; Cloudflare khuyến nghị nhà vận hành dùng SGLang 0.5.22 hoặc mới hơn.
Điều kiện nào khiến cụm tự vận hành gặp rủi ro?
| Điều kiện | Rủi ro |
|---|---|
| SGLang cũ ở chế độ prefill/decode tách rời | Đường từ chối có thể chuyển trạng thái không đầy đủ |
| Context window lớn hơn KV pool thực tế | Prompt hợp lệ theo API nhưng không vừa bộ nhớ |
| Trang nhớ dùng lại giữa nhiều yêu cầu | Dữ liệu cũ có thể còn nếu ghi đè không đầy đủ |
| Chỉ kiểm tra HTTP status | Phản hồi sai hoặc lộ dữ liệu vẫn có thể mang mã 200 |
| Nhiều khách dùng chung cụm | Sự cố trở thành vi phạm cô lập dữ liệu |
Checklist cho đội triển khai LLM đa người dùng
- Kiểm tra phiên bản SGLang; ưu tiên nâng lên 0.5.22 hoặc mới hơn theo khuyến nghị trong báo cáo.
- Đọc kích thước KV pool từ nhật ký và chỉ số của engine đang chạy, không suy từ dung lượng GPU hoặc cấu hình context.
- Gửi prompt ở sát, bằng và vượt ngưỡng bộ nhớ; xác minh cả mã lỗi, nội dung, độ dài token và thời gian phản hồi.
- Gắn chuỗi canary riêng cho từng phiên kiểm thử để phát hiện nội dung xuất hiện sai yêu cầu.
- Không ghi prompt, token hoặc nội dung khách hàng đầy đủ vào log dùng chung; tách quyền truy cập và thời gian giữ dữ liệu.
- Kiểm thử đường hủy yêu cầu, timeout, node decode mất kết nối và chuyển cache chưa hoàn tất.
- Bật checksum hoặc canary KV khi kiến trúc mô hình hỗ trợ, đồng thời xác minh log cho thấy cơ chế thật sự hoạt động.
- Nếu phát hiện lộ dữ liệu, ngừng model bị ảnh hưởng, giữ bằng chứng, xác định phạm vi khách hàng và kích hoạt quy trình thông báo sự cố.
Bài học kiến trúc
Tối ưu GPU thường giảm chi phí bằng cách dùng chung bộ nhớ và tách prefill khỏi decode. Nhưng mỗi tối ưu tạo thêm trạng thái phân tán cần được kiểm soát như dữ liệu nhạy cảm. Kiểm thử bảo mật phải bao phủ lỗi, hủy, quá tải và chuyển trạng thái dở dang, không chỉ đo token/giây trong luồng thành công.
Sự cố có ảnh hưởng mọi mô hình Workers AI không?
Không. Cloudflare xác nhận GLM-5.3 là mô hình duy nhất bị ảnh hưởng trong sự cố này.
Có bằng chứng kẻ tấn công cố ý khai thác không?
Cloudflare cho biết không tìm thấy bằng chứng khai thác có chủ đích; 155 phản hồi bị ảnh hưởng phù hợp với hoạt động dùng ngữ cảnh dài thông thường.
Chỉ tăng KV pool có đủ không?
Không nên dựa vào cấu hình đơn lẻ. Cần sửa đường từ chối, xác minh số token chuyển và kiểm thử dữ liệu chéo giữa nhiều phiên.
Nguồn tham khảo
Nếu đội của bạn tự vận hành SGLang, hãy gửi phiên bản, mô hình, chế độ prefill/decode, context window, loại GPU và kích thước KV pool quan sát được tới hotro@thuemaychu.vn. Không gửi prompt thật hoặc dữ liệu khách hàng; mục tiêu là lập bài kiểm thử cô lập an toàn.
Cần máy chủ cho workload này?
NOC thuemaychu.vn hỗ trợ chọn CPU, GPU và băng thông. PoC trong 24 giờ.
Bài viết liên quan
 Bảo mật
 môi trường huấn luyện AI: 7 lớp kiểm soát đáng học
OpenAI công bố ngày 23/10/2026 cách hãng cô lập môi trường huấn luyện frontier: microVM, mạng hạn chế, giám sát liên tục và red-team bằng nhiều AI agent.
 GPU / AI
llm-d 1.0: khi nào nên dùng suy luận LLM phân tán?
Google công bố llm-d 1.0, ngăn xếp mã nguồn mở để phân phối suy luận LLM trên Kubernetes. Bài viết phân tích tính năng, số liệu do hãng công bố và khi nào kiến trúc này đáng dùng.
 GPU / AI
Cloudflare giảm 68% chi phí AI code review: 6 bài học triển khai
Cloudflare cho biết chi phí trung bình của hệ thống AI code reviewer giảm từ 2,43 USD xuống 0,77 USD sau tối ưu. Giá trị lớn nhất với đội AI là phương pháp đo, phân tầng và cắt token, không phải con số áp dụng cho mọi hệ thống.